Investigadores de Meta proponen dar a los modelos control total sobre su propio contexto
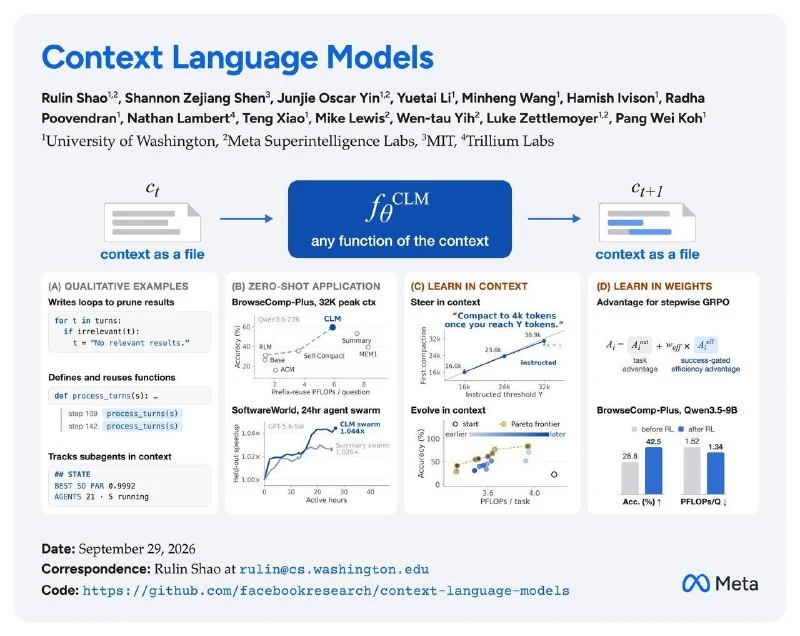
Los Context Language Models (CLM) eliminan la lógica predefinida de gestión de contexto y permiten que el modelo reescriba su historial en un archivo accesible mediante Bash, reduciendo los costes de cómputo en tareas largas.
Investigadores de Meta han propuesto Context Language Models (CLM), un enfoque que da a los modelos control total sobre su propio contexto.
Normalmente, el contexto de un agente se gestiona con una regla simple: contexto antiguo + nueva respuesta -> nuevo contexto. Cuando el historial crece demasiado, hay que comprimirlo o limpiarlo por separado.
En CLM, los autores proponen eliminar por completo la lógica predefinida de gestión de contexto y permitir que el modelo reescriba su propia historia.
Técnicamente, todo el contexto actual se almacena en un archivo normal al que el modelo tiene acceso mediante Bash. El modelo puede eliminar mensajes innecesarios en cualquier momento, sustituir un fragmento grande del historial por una nota corta, conservar un resultado importante literalmente o reestructurar completamente el contenido. Después de cada cambio, el archivo se convierte en el nuevo contexto del modelo.
No se dan reglas explícitas sobre cómo gestionar el historial. En los experimentos, los agentes empezaron a crear notas dentro del contexto, a escribir funciones para eliminar resultados de búsqueda antiguos y a construir tablas compactas con el estado de otros agentes. Por ejemplo, en una prueba, un modelo mantuvo el contexto de trabajo entre 6–8K tokens durante 163 ediciones.
Los autores fueron más allá e intentaron entrenar al modelo para esta habilidad mediante aprendizaje por refuerzo (RL). Tras entrenar Qwen3.5-9B en BrowseComp-Plus, el rendimiento pasó del 28.8% al 42.5%, mientras que el cómputo fue un 38.8% menor que el de un baseline entrenado de la misma forma con resumen ordinario.
Sin embargo, la edición arbitraria del contexto rompe el caché estándar. Si se cambia algo en el medio del historial, todos los estados posteriores deben recalcularse formalmente. Los autores introdujeron Suffix Cache Reuse: para las partes del contexto que no cambian, siguen usando el KV-cache antiguo aunque el texto anterior haya cambiado. En los experimentos, esto redujo el cómputo del servidor en otro ~35% sin una pérdida notable de calidad.
En tareas largas, la diferencia se vuelve sustancial. En una ejecución de 12 horas de EdgeBench, CLM obtuvo un 5% más de puntos mientras reducía el cómputo en un 59%. En una prueba de 24 horas de optimización de código, CLM logró un resultado un 65% mejor que el baseline con el mismo presupuesto de cómputo.
Todo esto funciona sobre LLM normales, sin cambiar la arquitectura del modelo.
Por qué es importante
AnálisisEsto importa porque el contexto autogestionado puede reducir los costes de inferencia y hacer que los agentes de IA sean más autónomos en tareas largas y de múltiples pasos.
Debatir en la comunidad
Comparte tus preguntas e ideas con desarrolladores
Relacionado en el ecosistema
Guías prácticas, terminología y skills de agentes
Familia Llama (Meta Llama)
Serie de modelos de lenguaje fundamentales y abiertos de Meta (Llama 3, 3.1, 3.3) que se han convertido en el estándar industrial de la ecosistema Open Weights, IA local y fine-tuning corporativo.
Meta Llama (Estándar Abierto Principal de Inteligencia Artificial)
Serie insignia de modelos de lenguaje abiertos de Meta (Llama 3, 3.3). Disponible para descarga gratuita, modificación y ejecución local en servidores propios sin restricciones ni censura.
Jev y System One AI: guía práctica completa del modelo de decisiones de TypeSafe
Análisis ingenieril profundo del modelo insignia Jev: arquitectura System One frente a LLM, primitivas Choice/Score/Noul, paralelismo de consultas, matemática de la confianza, casos de vídeo, código y revisión de alternativas open-weight locales (Laya, GLiNER2.5, CLM-8B).
DeepSeek abre el código de parte de su interfaz de chat
DeepSeek publicó el código fuente de una parte de la interfaz de su chat, con búsqueda en Internet, modo de razonamiento profundo e historial.