GPT Image 2.6 vs Seedream 5.5 : test de génération de photos
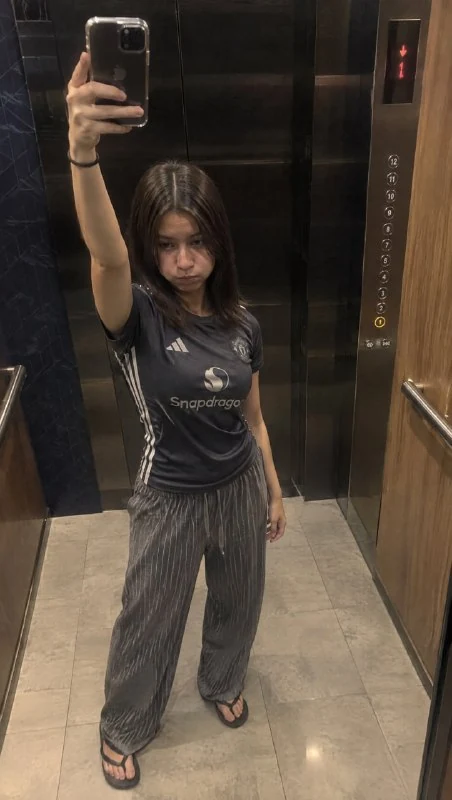
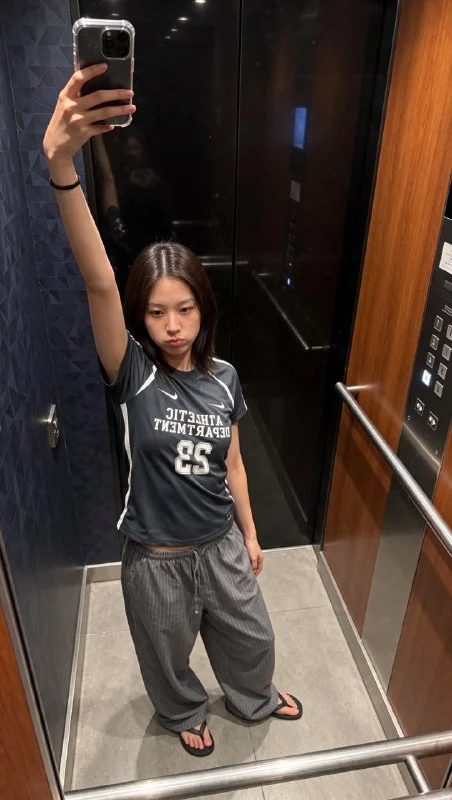
GPT Image 2.6 et Seedream 5.5 ont été comparés sur une photo réaliste dans un ascenseur : le modèle chinois imite mieux le selfie iPhone, mais garde des défauts de détail.
GPT Image 2.6 vs Seedream 5.5 : test de génération de photos
GPT Image 2.6 a sauté le sixième étage, tandis que Seedream 5.5 n'a pas géré les boutons. En imitant des photos prises avec un iPhone, le modèle chinois paraît clairement meilleur, mais sur une jambe on retrouve les classiques six doigts.
Une image avec Seedream 5.5 ne coûte qu'un centime, et le modèle est disponible via Syntx AI. Si l'on évite les polices et la typographie, je le trouve plus convaincant. ChatGPT imite la photo comme si elle avait été prise avec un très vieil iPhone et d'autres algorithmes de traitement d'image.
À gauche — Image 2.6, à droite — Seedream.
Le prompt était identique :
Create this image with maximum photographic accuracy.
Scene: A casual full-body mirror selfie inside a modern, dimly lit elevator. Dark navy geometric patterned wall panels on the left, warm brown wood-paneled walls on the right, black reflective elevator doors in the center, illuminated elevator buttons, horizontal silver handrails, and a light gray tiled floor.
Subject: A young woman with straight, shoulder-length dark brown hair parted in the middle, natural facial features, and minimal makeup. She is standing slightly angled toward the mirror, holding a black iPhone with a transparent protective case high above her head with her right arm fully extended. Her phone is positioned in the upper-left corner of the composition. She looks slightly downward at the mirror with puffed cheeks and a playful, serious expression. Her left arm hangs naturally beside her body.
Outfit: A fitted dark charcoal-gray short-sleeve athletic jersey with white side stripes, white sports logos and lettering across the chest, loose oversized gray pinstriped pajama-style pants, and simple black flip-flops. A thin black hair tie around her raised wrist.
Composition: Vertical 9:16 smartphone photo, full-body framing from a slightly elevated mirror-selfie perspective. Subject positioned slightly left of center, raised arm creating a strong diagonal, legs relaxed and slightly apart. Preserve the exact pose, body proportions, camera angle, perspective, outfit, background layout, and framing of the reference.
Photography: Authentic unedited iPhone mirror selfie. Warm overhead elevator lighting mixed with cool ambient reflections, slightly underexposed shadows, realistic skin texture, subtle smartphone grain, natural reflections, imperfect sharpness, and ordinary indoor white balance.
CRITICAL: The result must look like a real spontaneous smartphone snapshot, NOT an AI-generated photograph. No cinematic lighting, no professional photography, no beauty filters, no skin smoothing, no HDR, no artificial sharpness, no color grading, no stylization. Preserve the original reference's realistic colors, exposure, shadows, visual imperfections, and casual everyday aesthetic.
Pourquoi c'est important
AnalyseLa comparaison montre que les modèles d'IA plus économiques pour la génération d'images peuvent paraître plus réalistes sur des photos du quotidien, mais échouent encore sur les petits détails et la typographie.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs
Lié dans l'écosystème
Guides pratiques, terminologie clé et compétences d'agents
GPT Image / DALL-E (Génération d'images dans ChatGPT)
Outil intégré de génération de contenu visuel directement dans l'interface de dialogue avec ChatGPT. Permet de créer des illustrations, du concept art, des affiches et de modifier localement des parties spécifiques d'une image.
Negative Prompts in Image Generation
A control mechanism for generation in diffusion models (Stable Diffusion, Midjourney --no) that directs the mathematical noise-cleaning vector away from undesired imagery. Used to filter out artifacts such as extra limbs, blurriness, watermarks, and cartoonish styles.
MiniMax lance H3-Image avec de la 4K native
Le nouveau générateur d’images basé sur H3 produit des images natives en 4096×4096 en six étapes et prend en charge des prompts longs et plusieurs références.
Prompting en 2026 : ChatGPT, Claude, génération d'images et tâches professionnelles
La plupart des personnes utilisent l'IA comme un moteur de recherche : elles saisissent une requête courte, lisent la réponse en diagonale puis ferment l'onglet. Pour des informations factuelles, cela fonctionne. Pour tout ce qui compte réellement, ce n'est pas le cas.