GPT Image 2.6 vs. Seedream 5.5: prueba de generación de fotos
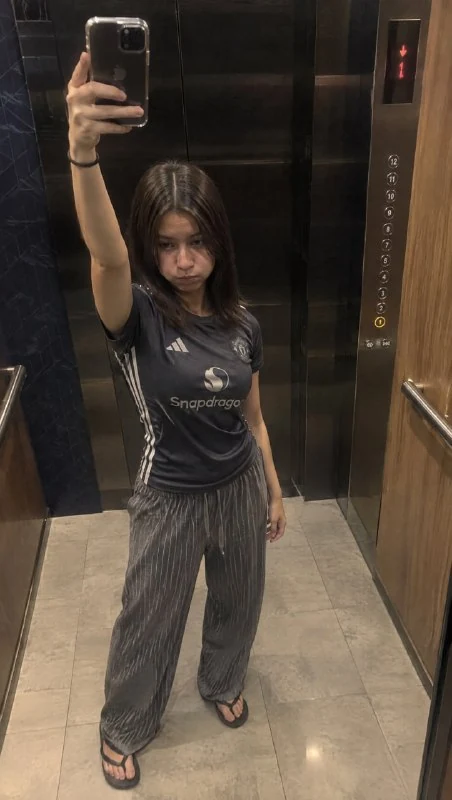
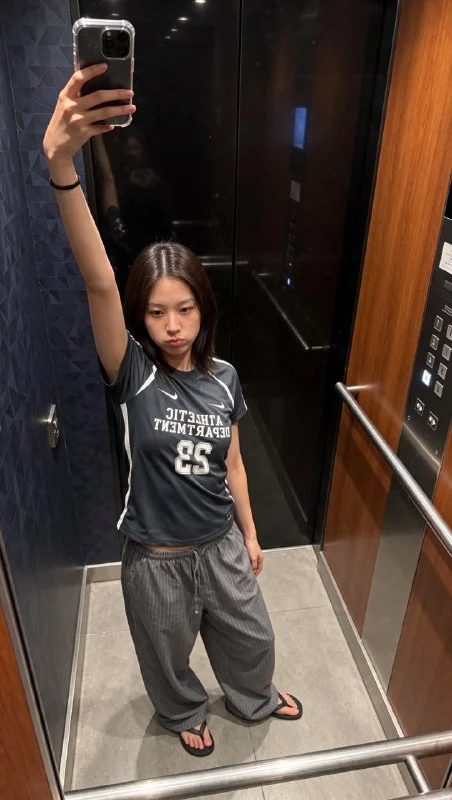
Se comparó GPT Image 2.6 y Seedream 5.5 con una foto realista en un ascensor: el modelo chino imita mejor la foto de iPhone, pero sigue fallando en detalles.
GPT Image 2.6 vs. Seedream 5.5: prueba de generación de fotos
GPT Image 2.6 se saltó el sexto piso, mientras que Seedream 5.5 no supo manejar los botones. Al imitar fotos de iPhone, el modelo chino se ve claramente mejor, pero en una pierna vuelve a mostrar los clásicos seis dedos.
Una imagen en Seedream 5.5 cuesta solo un centavo y el modelo está disponible a través de Syntx AI. Si se evitan las fuentes y la tipografía, me gusta más. ChatGPT imita la foto como si fuera hecha con un iPhone muy antiguo y con otros algoritmos de procesamiento.
A la izquierda — Image 2.6, a la derecha — Seedream.
El prompt fue idéntico:
Create this image with maximum photographic accuracy.
Scene: A casual full-body mirror selfie inside a modern, dimly lit elevator. Dark navy geometric patterned wall panels on the left, warm brown wood-paneled walls on the right, black reflective elevator doors in the center, illuminated elevator buttons, horizontal silver handrails, and a light gray tiled floor.
Subject: A young woman with straight, shoulder-length dark brown hair parted in the middle, natural facial features, and minimal makeup. She is standing slightly angled toward the mirror, holding a black iPhone with a transparent protective case high above her head with her right arm fully extended. Her phone is positioned in the upper-left corner of the composition. She looks slightly downward at the mirror with puffed cheeks and a playful, serious expression. Her left arm hangs naturally beside her body.
Outfit: A fitted dark charcoal-gray short-sleeve athletic jersey with white side stripes, white sports logos and lettering across the chest, loose oversized gray pinstriped pajama-style pants, and simple black flip-flops. A thin black hair tie around her raised wrist.
Composition: Vertical 9:16 smartphone photo, full-body framing from a slightly elevated mirror-selfie perspective. Subject positioned slightly left of center, raised arm creating a strong diagonal, legs relaxed and slightly apart. Preserve the exact pose, body proportions, camera angle, perspective, outfit, background layout, and framing of the reference.
Photography: Authentic unedited iPhone mirror selfie. Warm overhead elevator lighting mixed with cool ambient reflections, slightly underexposed shadows, realistic skin texture, subtle smartphone grain, natural reflections, imperfect sharpness, and ordinary indoor white balance.
CRITICAL: The result must look like a real spontaneous smartphone snapshot, NOT an AI-generated photograph. No cinematic lighting, no professional photography, no beauty filters, no skin smoothing, no HDR, no artificial sharpness, no color grading, no stylization. Preserve the original reference's realistic colors, exposure, shadows, visual imperfections, and casual everyday aesthetic.
Por qué es importante
AnálisisLa comparación muestra que los modelos de IA más baratos para generar imágenes pueden verse más realistas en fotos cotidianas, pero aún fallan en detalles pequeños y tipografía.
Debatir en la comunidad
Comparte tus preguntas e ideas con desarrolladores
Relacionado en el ecosistema
Guías prácticas, terminología y skills de agentes
GPT Image / DALL-E (Generación de Imágenes en ChatGPT)
Herramienta integrada de generación de contenido visual directamente en el diálogo con ChatGPT. Permite crear ilustraciones, arte conceptual, textos para carteles y editar fragmentos de imágenes localmente.
Prompts Negativos en Generación de Imágenes
Mecanismo de control en modelos de difusión (Stable Diffusion, Midjourney --no) que dirige el vector matemático de limpieza de ruido en dirección opuesta a imágenes no deseadas. Se utiliza para filtrar artefactos: extremidades adicionales, desenfoque, marcas de agua y estilo caricaturesco.
MiniMax presenta H3-Image con 4K nativo
El nuevo generador de imágenes basado en H3 produce imágenes nativas de 4096×4096 en seis pasos y admite prompts largos y múltiples referencias.
Guía de prompts para los modelos generativos GPT Image
Los modelos de generación de imágenes gpt-image de OpenAI están diseñados para obtener visuales de calidad de producción y procesos creativos totalmente controlables. Son adecuados...