Порівняння GPT Image 2.6 і Seedream 5.5: тест генерації фото
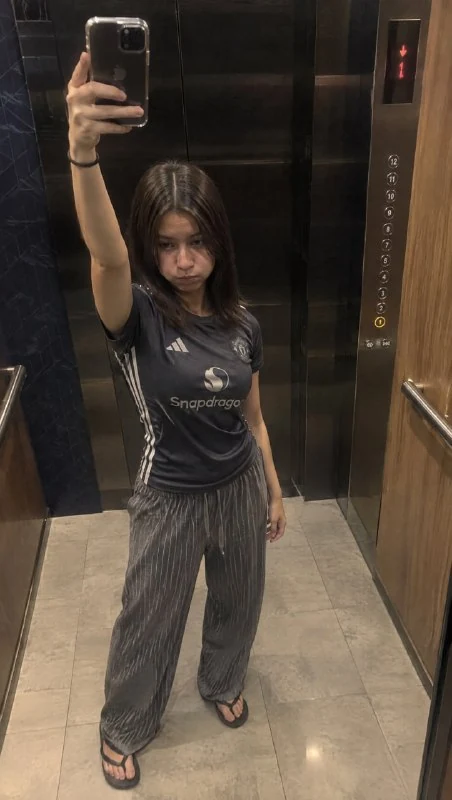
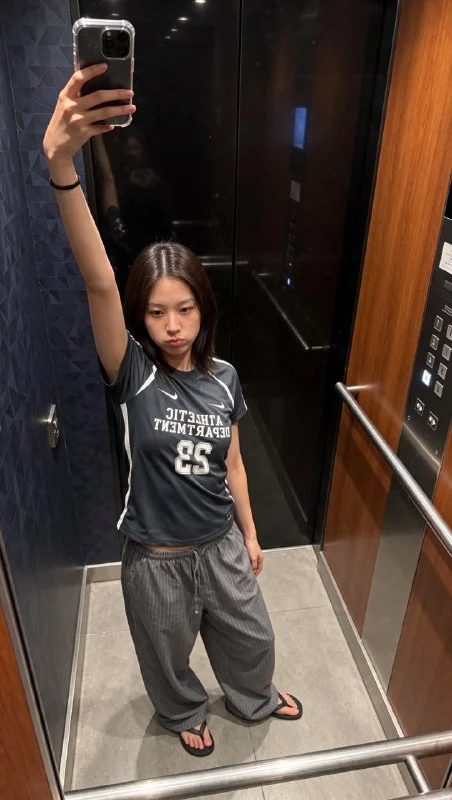
GPT Image 2.6 і Seedream 5.5 порівняли на реалістичному фото в ліфті: китайська модель краще імітує знімок iPhone, але має проблеми з деталями.
Порівняння GPT Image 2.6 і Seedream 5.5: тест генерації фото
GPT Image 2.6 пропустив шостий поверх, а Seedream 5.5 не впорався з кнопками. В імітації фото з iPhone китайська модель виглядає реалістичніше, але на одній нозі знову видно класичні шість пальців.
Вартість однієї картинки в Seedream 5.5 — лише один цент, і модель доступна через Syntx AI. Якщо уникати шрифтів і типографіки, цей результат подобається більше. ChatGPT імітує знімок так, ніби він зроблений на дуже старий iPhone з іншими алгоритмами обробки фото.
Ліворуч — Image 2.6, праворуч — Seedream.
Промт був однаковим:
Create this image with maximum photographic accuracy.
Scene: A casual full-body mirror selfie inside a modern, dimly lit elevator. Dark navy geometric patterned wall panels on the left, warm brown wood-paneled walls on the right, black reflective elevator doors in the center, illuminated elevator buttons, horizontal silver handrails, and a light gray tiled floor.
Subject: A young woman with straight, shoulder-length dark brown hair parted in the middle, natural facial features, and minimal makeup. She is standing slightly angled toward the mirror, holding a black iPhone with a transparent protective case high above her head with her right arm fully extended. Her phone is positioned in the upper-left corner of the composition. She looks slightly downward at the mirror with puffed cheeks and a playful, serious expression. Her left arm hangs naturally beside her body.
Outfit: A fitted dark charcoal-gray short-sleeve athletic jersey with white side stripes, white sports logos and lettering across the chest, loose oversized gray pinstriped pajama-style pants, and simple black flip-flops. A thin black hair tie around her raised wrist.
Composition: Vertical 9:16 smartphone photo, full-body framing from a slightly elevated mirror-selfie perspective. Subject positioned slightly left of center, raised arm creating a strong diagonal, legs relaxed and slightly apart. Preserve the exact pose, body proportions, camera angle, perspective, outfit, background layout, and framing of the reference.
Photography: Authentic unedited iPhone mirror selfie. Warm overhead elevator lighting mixed with cool ambient reflections, slightly underexposed shadows, realistic skin texture, subtle smartphone grain, natural reflections, imperfect sharpness, and ordinary indoor white balance.
CRITICAL: The result must look like a real spontaneous smartphone snapshot, NOT an AI-generated photograph. No cinematic lighting, no professional photography, no beauty filters, no skin smoothing, no HDR, no artificial sharpness, no color grading, no stylization. Preserve the original reference's realistic colors, exposure, shadows, visual imperfections, and casual everyday aesthetic.
Чому це важливо
АналітикаПорівняння показує, що дешевші ШІ-моделі для генерації зображень можуть виглядати реалістичніше у повсякденних фото, але досі помиляються на дрібних деталях і типографіці.
Обговорити новину у спільноті
Діліться своїм досвідом та думками з ШІ-розробниками
Пов'язані матеріали екосистеми
Практичні гайди, термінологія та агентські скіли
GPT Image / DALL-E (Генерація зображень у ChatGPT)
Вбудований інструмент генерації візуального контенту безпосередньо у діалозі з ChatGPT. Дозволяє створювати ілюстрації, концепт-арт, постерні написи та локально редагувати фрагменти зображень.
Негативні промпти в генерації зображень (Negative Prompts)
Механізм керування генерацією у дифузійних моделях (Stable Diffusion, Midjourney --no), що спрямовує математичний вектор очищення шуму в протилежний бік від небажаних образів. Використовується для фільтрації артефактів: зайвих кінцівок, розмиття, водяних знаків та мультяшності.
MiniMax представила H3-Image із нативним 4K
Новий генератор зображень на базі H3 створює нативні зображення 4096×4096 за 6 кроків і підтримує довгі промпти та референси.
Промпт-гайд по генеративним моделям GPT Image
Моделі генерації зображень gpt-image від OpenAI створені для отримання візуалів виробничої якості та повністю керованих творчих процесів. Вони підходять як для професійних дизайн-з...