Google dévoile l'architecture SKILL.state pour optimiser la consommation de tokens des agents IA
Des chercheurs de Google ont mis au point SKILL.state, une nouvelle architecture qui remplace l'historique de dialogue par un état d'exécution structuré, réduisant drastiquement les coûts en tokens tout en améliorant la précision des agents.
Google Introduces SKILL.state Architecture to Save Tokens in Agent Sessions
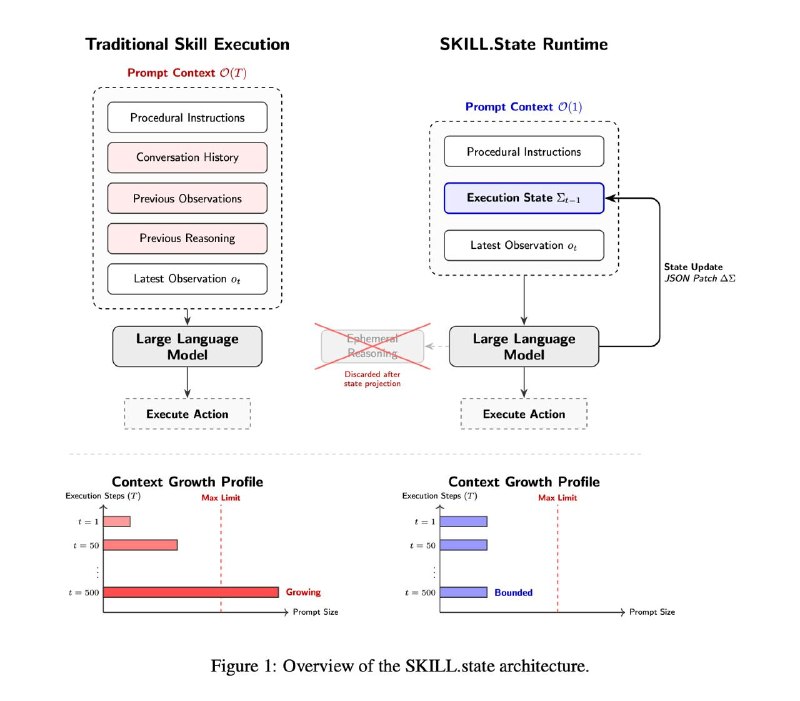
Les auteurs proposent l'architecture SKILL.state : plutôt que d'accumuler l'historique du dialogue, elle utilise un état d'exécution explicite, mutable et structuré.
Habituellement, les agents fonctionnent selon le principe ReAct, ce qui signifie qu'à chaque étape, l'intégralité du dialogue accumulé est réinjectée dans le modèle. Cela entraîne une croissance linéaire de la taille du prompt à chaque itération, tandis que la consommation totale de tokens pour l'ensemble de l'exécution croît de manière quadratique. De plus, le modèle est contraint d'extraire l'état actuel de la tâche d'une masse de texte, ce qui peut parfois provoquer des hallucinations.
L'article suggère plutôt d'envoyer au modèle, à chaque étape, un état d'exécution explicite, mutable et structuré (désigné comme « execution state »). Voici comment cela fonctionne :
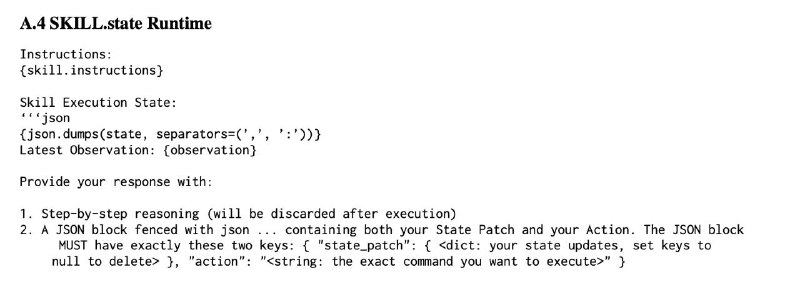
– À chaque étape, le modèle, en plus de son raisonnement, génère un bloc JSON contenant deux champs : (1) une commande spécifique que l'agent doit exécuter dans l'environnement ; (2) state_patch – les informations concernant les modifications apportées par rapport à l'état précédent.
– L'agent exécute la commande et reçoit une réponse de l'environnement, puis l'état courant est mis à jour conformément au state_patch.
– Pour l'étape suivante, seuls l'état mis à jour, le prompt système et la dernière réponse de l'environnement sont transmis. Aucun message antérieur, aucun raisonnement du modèle issu des étapes précédentes ni aucune autre donnée ne sont inclus.
Ainsi, la taille du prompt reste constante à chaque étape, et les coûts totaux en tokens augmentent de manière linéaire.
Dans un benchmark synthétique de gestion d'entrepôt, SKILL.state économise 93,8 % des tokens sur 100 étapes, et 98 % sur 200 étapes. Plus le contexte est long, plus l'écart devient spectaculaire.
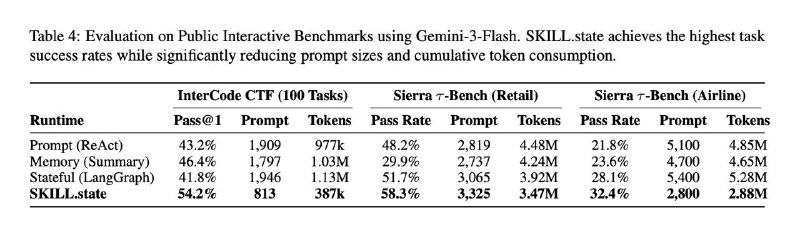
Sur des benchmarks réels, les économies sont légèrement inférieures, mais SKILL.state surpasse parfois même les modèles de base en termes de précision. Par exemple, sur le benchmark InterCode CTF, il atteint 54,2 % contre 40-45 % pour les solutions comparatives. Cela s'explique par le fait que la représentation de la tâche via un état offre une vue plus claire et moins encombrée, débarrassée des faits distractifs et des hypothèses erronées issus des contextes passés.
Cette solution peut être appliquée à n'importe quel modèle, y compris ceux à code source fermé, simplement en modifiant l'environnement d'exécution (runtime). L'annexe A fournit le gabarit de prompt nécessaire, permettant ainsi une adoption immédiate.
Pourquoi c'est important
AnalyseCette architecture réduit considérablement les coûts opérationnels liés aux tokens, un facteur critique pour l'efficacité économique des agents autonomes. Elle améliore également la fiabilité des tâches complexes en minimisant les risques d'hallucination dus à la saturation du contexte.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs
Lié dans l'écosystème
Guides pratiques, terminologie clé et compétences d'agents
JSON — données structurées pour les applications, les API et les agents IA
Guide pratique complet du format JSON : règles de syntaxe, sérialisation via parse/stringify, intégration avec les API REST, schémas JSON et sortie structurée pour l'intelligence artificielle.
Opérateur IA autonome sur Telegram 24/7 : architecture, Telethon, sécurité et 10 cas d'usage opérationnels
Guide d'ingénierie complet pour la création d'un opérateur IA prêt pour la production sur Telegram basé sur Telethon : isolation des sessions, système de confirmation, protection contre les bannissements et déploiement 24/7.
Mémoire à court et long terme des agents
Architecture de mémoire hiérarchique pour les agents autonomes. Distinction entre la mémoire à court terme (Short-Term Memory — fenêtre contextuelle active de la session en cours) et la mémoire à long terme (Long-Term Memory — bases de données vectorielles, fichiers de profil utilisateur et journaux épisodiques).
Gemini Flash & Pro (Google Gemini)
La famille de modèles multimodaux de Google DeepMind, qui combine une fenêtre contextuelle record (jusqu'à 2 millions de tokens), une vitesse de génération extrême (plus de 150 tokens/s) et une perception native de la vidéo et de l'audio.