Google stellt SKILL.state-Architektur vor: Revolutionäre Token-Einsparung in Agenten-Sessions
Forscher von Google haben die SKILL.state-Architektur entwickelt, die den Token-Verbrauch bei KI-Agenten drastisch senkt und gleichzeitig die Genauigkeit erhöht.
Google stellt SKILL.state-Architektur vor: Revolutionäre Token-Einsparung in Agenten-Sessions
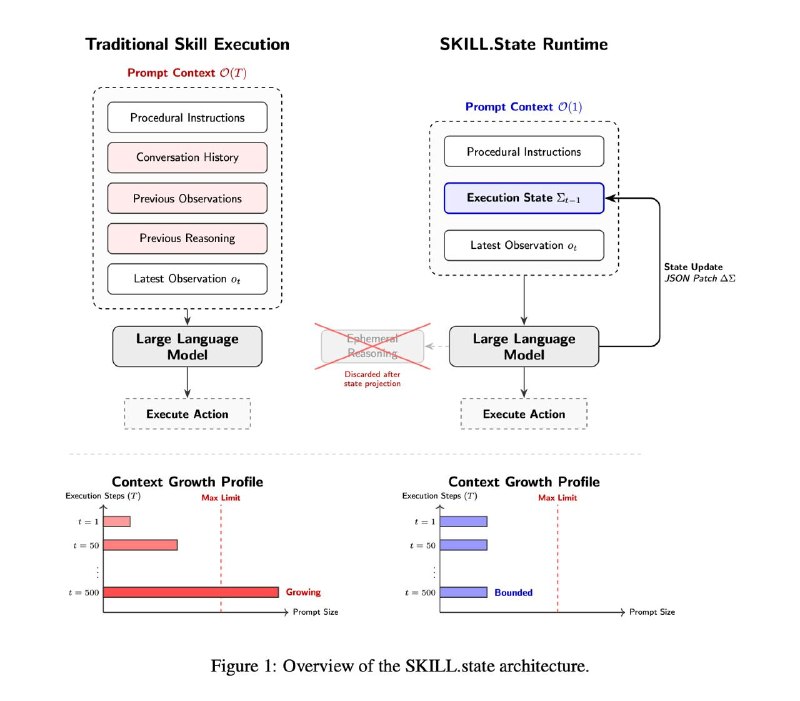
Die Autoren schlagen die SKILL.state-Architektur vor: Anstatt den Dialogverlauf kumulativ zu speichern, nutzt sie einen expliziten, veränderbaren strukturierten Ausführungsstatus.
Üblicherweise arbeiten Agenten nach dem ReAct-Prinzip. Das bedeutet, dass bei jedem Schritt der gesamte angesammelte Dialogverlauf erneut an das Modell übergeben wird. Dies führt dazu, dass die Prompt-Länge linear wächst, während der gesamte Token-Verbrauch für eine Sitzung quadratisch ansteigt. Zudem ist das Modell gezwungen, den aktuellen Aufgabenstatus aus einem Berg von Text herauszufiltern, was häufig Halluzinationen begünstigt.
Der Artikel schlägt stattdessen vor, dem Modell bei jedem Schritt einen expliziten, veränderbaren strukturierten Ausführungsstatus (im Artikel als "execution state" bezeichnet) zu senden. So funktioniert es:
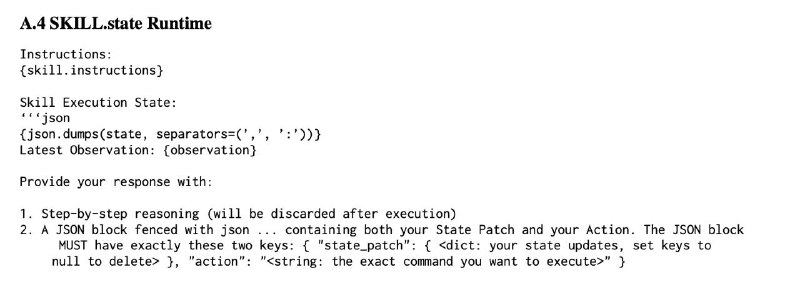
– Bei jedem Schritt gibt das Modell neben dem Reasoning einen JSON-Block mit zwei Feldern aus: (1) einen spezifischen Befehl, den der Agent in der Umgebung ausführen muss; (2) state_patch – Informationen darüber, was sich im Vergleich zum vorherigen Status geändert hat.
– Der Agent führt den Befehl aus, erhält eine Antwort von der Umgebung und aktualisiert den aktuellen Status gemäß dem state_patch.
– Für den nächsten Schritt werden nur der aktualisierte Status, der System-Prompt und die letzte Antwort der Umgebung übergeben. Keine früheren Nachrichten, kein Reasoning des Modells aus vergangenen Schritten oder sonstiger Ballast.
Dadurch bleibt die Prompt-Größe bei jedem Schritt konstant, und die gesamten Token-Kosten wachsen nur noch linear.
In einem synthetischen Benchmark für Lagerverwaltung spart SKILL.state 93,8 % der Tokens bei 100 Schritten und 98 % bei 200 Schritten. Je länger der Kontext, desto dramatischer die Einsparung.
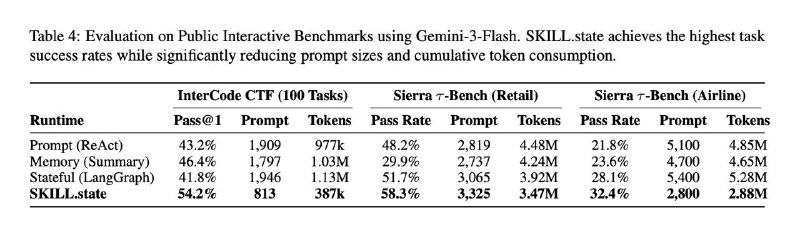
In realen Benchmarks sind die Einsparungen etwas geringer, aber SKILL.state erzielt teilweise sogar eine höhere Genauigkeit. Im InterCode-CTF-Benchmark erreicht es beispielsweise 54,2 %, verglichen mit 40–45 % für Baseline-Modelle. Dies liegt daran, dass die Darstellung der Aufgabe durch den Status ein klareres, weniger überladenes Bild ergibt, das frei von ablenkenden Fakten und falschen Hypothesen aus früheren Kontexten ist.
Diese Lösung kann auf jedes Modell angewendet werden, auch auf geschlossene Modelle, indem einfach die Runtime angepasst wird. Anhang A liefert die erforderliche Prompt-Vorlage, sodass diese direkt übernommen und genutzt werden kann.
Warum das wichtig ist
AnalyseDiese neue Architektur senkt die Betriebskosten für KI-Agenten erheblich, was für deren Skalierbarkeit entscheidend ist. Gleichzeitig verbessert sie die Zuverlässigkeit und Genauigkeit der Aufgabenausführung.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern