Google Apresenta Arquitetura SKILL.state para Reduzir o Consumo de Tokens em Sessões de Agentes
Pesquisadores da Google desenvolveram a arquitetura SKILL.state, que substitui o histórico acumulado por um estado de execução estruturado e mutável, reduzindo drasticamente o consumo de tokens.
Google Introduz a Arquitetura SKILL.state para Otimizar Sessões de Agentes
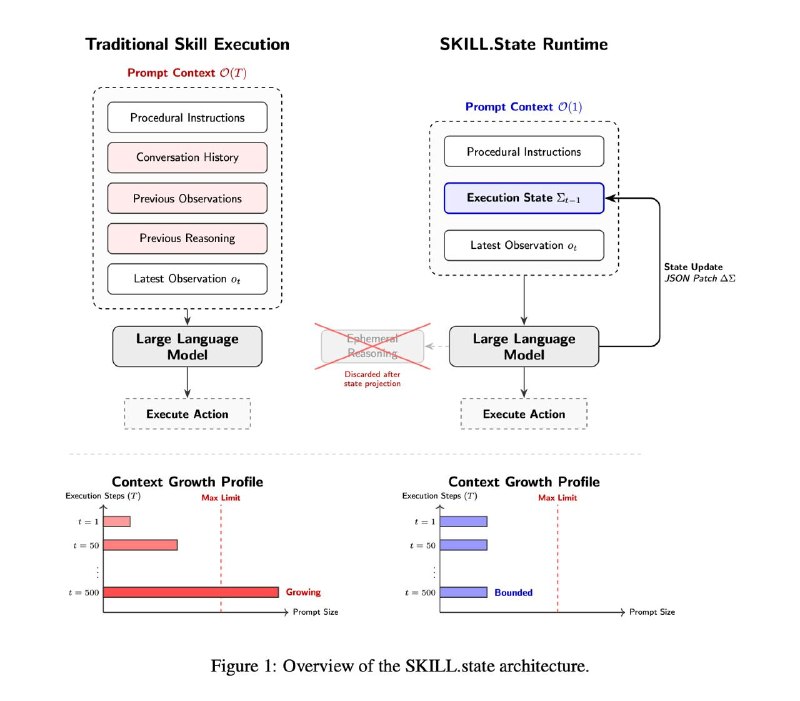
Os autores propõem a arquitetura SKILL.state: em vez de acumular o histórico do diálogo, ela utiliza um estado de execução explícito, mutável e estruturado.
Normalmente, os agentes operam sob o princípio estilo ReAct, o que significa que, em cada etapa, todo o diálogo acumulado é reenviado ao modelo. Isso faz com que o prompt cresça linearmente a cada iteração, enquanto o consumo total de tokens para toda a execução cresce quadraticamente. Além disso, o modelo é forçado a extrair o estado atual da tarefa de uma montanha de texto a cada passo, o que pode provocar alucinações.
O artigo sugere, em vez disso, enviar ao modelo um estado de execução estruturado e mutável (referido como execution state) a cada etapa. Veja como funciona:
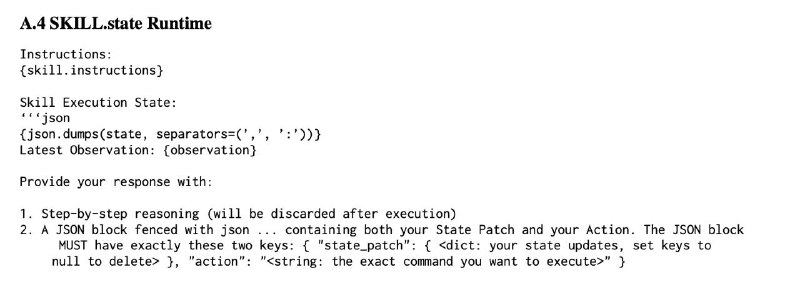
– Em cada passo, além do raciocínio, o modelo gera um bloco JSON com dois campos: (1) um comando específico que o agente deve executar no ambiente; (2) state_patch – informações sobre o que mudou em relação ao estado anterior.
– O agente executa o comando e recebe uma resposta do ambiente, e o estado atual é atualizado de acordo com o state_patch.
– Para o próximo passo, são passados apenas o estado atualizado, o prompt do sistema e a última resposta do ambiente. Nenhuma mensagem anterior, raciocínio do modelo de etapas passadas ou qualquer outro dado histórico.
Dessa forma, o tamanho do prompt em cada etapa torna-se constante, e os custos totais de tokens crescem linearmente.
Em um benchmark sintético de gestão de armazém, o SKILL.state economiza 93,8% dos tokens em 100 passos e 98% em 200 passos. Quanto mais longo o contexto, mais dramática é a diferença.
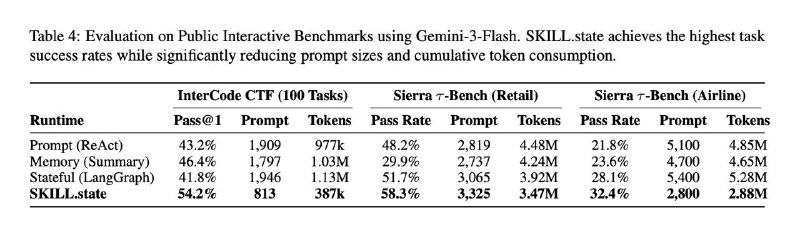
Nos benchmarks reais, as economias são ligeiramente menores, mas o SKILL.state às vezes supera até mesmo na precisão. Por exemplo, no InterCode CTF, ele atinge 54,2%, comparado aos 40-45% das linhas de base. Isso ocorre porque representar a tarefa através do estado resulta em uma visão mais limpa e menos poluída, livre de fatos distrativos e hipóteses incorretas de contextos anteriores.
Essa solução pode ser aplicada a qualquer modelo, inclusive fechados, simplesmente alterando o tempo de execução (runtime). O Apêndice A fornece o template de prompt necessário, permitindo que seja adotado e utilizado imediatamente.
Por que isso importa
AnáliseEsta nova arquitetura reduz significativamente os custos de tokens, um fator crítico para a eficiência operacional dos agentes de IA. Além disso, ao simplificar o contexto fornecido ao modelo, ela pode melhorar a precisão na execução de tarefas complexas.
Debater na comunidade
Compartilhe suas dúvidas e insights com desenvolvedores