Google dévoile l'architecture SKILL.state pour optimiser la consommation de tokens des agents IA
Des chercheurs de Google ont mis au point SKILL.state, une nouvelle architecture qui remplace l'historique de dialogue par un état d'exécution structuré, réduisant drastiquement les coûts en tokens tout en améliorant la précision des agents.
Google Introduces SKILL.state Architecture to Save Tokens in Agent Sessions
Les auteurs proposent l'architecture SKILL.state : plutôt que d'accumuler l'historique du dialogue, elle utilise un état d'exécution explicite, mutable et structuré.
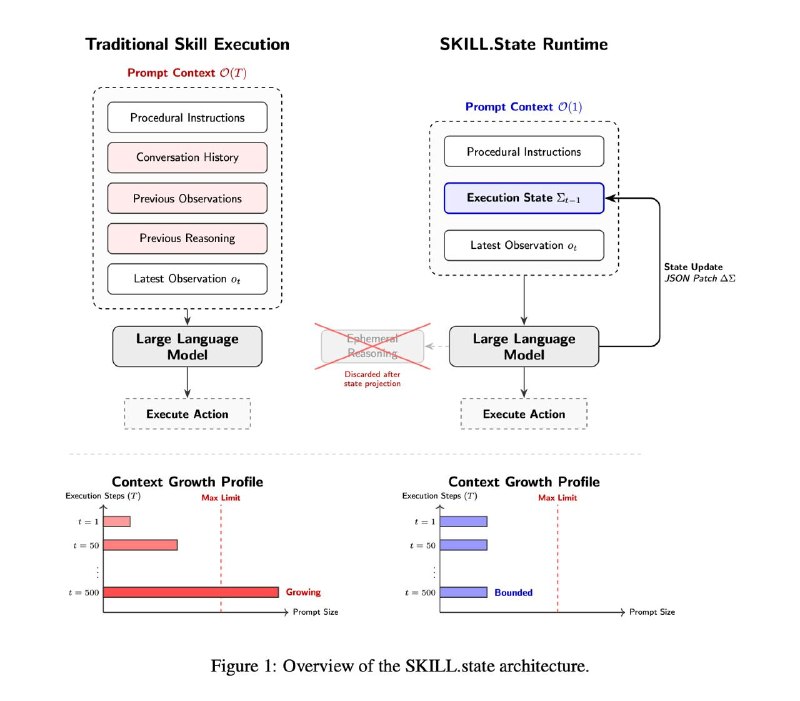
Habituellement, les agents fonctionnent selon le principe ReAct, ce qui signifie qu'à chaque étape, l'intégralité du dialogue accumulé est réinjectée dans le modèle. Cela entraîne une croissance linéaire de la taille du prompt à chaque itération, tandis que la consommation totale de tokens pour l'ensemble de l'exécution croît de manière quadratique. De plus, le modèle est contraint d'extraire l'état actuel de la tâche d'une masse de texte, ce qui peut parfois provoquer des hallucinations.
L'article suggère plutôt d'envoyer au modèle, à chaque étape, un état d'exécution explicite, mutable et structuré (désigné comme « execution state »). Voici comment cela fonctionne :
– À chaque étape, le modèle, en plus de son raisonnement, génère un bloc JSON contenant deux champs : (1) une commande spécifique que l'agent doit exécuter dans l'environnement ; (2) state_patch – les informations concernant les modifications apportées par rapport à l'état précédent.
– L'agent exécute la commande et reçoit une réponse de l'environnement, puis l'état courant est mis à jour conformément au state_patch.
– Pour l'étape suivante, seuls l'état mis à jour, le prompt système et la dernière réponse de l'environnement sont transmis. Aucun message antérieur, aucun raisonnement du modèle issu des étapes précédentes ni aucune autre donnée ne sont inclus.
Ainsi, la taille du prompt reste constante à chaque étape, et les coûts totaux en tokens augmentent de manière linéaire.
Dans un benchmark synthétique de gestion d'entrepôt, SKILL.state économise 93,8 % des tokens sur 100 étapes, et 98 % sur 200 étapes. Plus le contexte est long, plus l'écart devient spectaculaire.
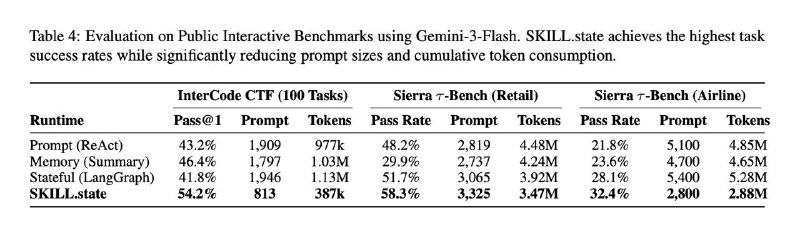
Sur des benchmarks réels, les économies sont légèrement inférieures, mais SKILL.state surpasse parfois même les modèles de base en termes de précision. Par exemple, sur le benchmark InterCode CTF, il atteint 54,2 % contre 40-45 % pour les solutions comparatives. Cela s'explique par le fait que la représentation de la tâche via un état offre une vue plus claire et moins encombrée, débarrassée des faits distractifs et des hypothèses erronées issus des contextes passés.
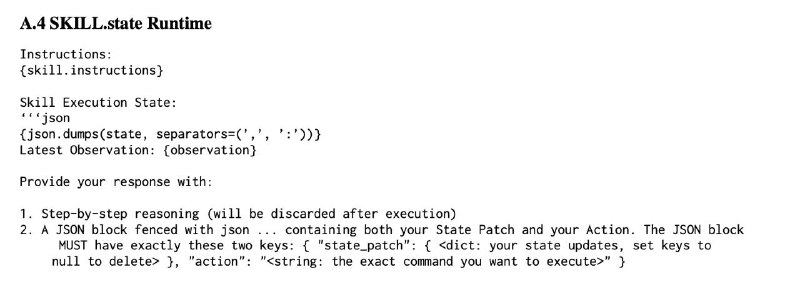
Cette solution peut être appliquée à n'importe quel modèle, y compris ceux à code source fermé, simplement en modifiant l'environnement d'exécution (runtime). L'annexe A fournit le gabarit de prompt nécessaire, permettant ainsi une adoption immédiate.
Pourquoi c'est important
AnalyseCette architecture réduit considérablement les coûts opérationnels liés aux tokens, un facteur critique pour l'efficacité économique des agents autonomes. Elle améliore également la fiabilité des tâches complexes en minimisant les risques d'hallucination dus à la saturation du contexte.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs