Исследователи Google представили архитектуру SKILL.state для экономии токенов на сессиях с агентами
Авторы разработали новую архитектуру SKILL.state, которая значительно снижает потребление токенов во время работы с агентами.
Исследователи Google представили архитектуру SKILL.state для экономии токенов на сессиях с агентами
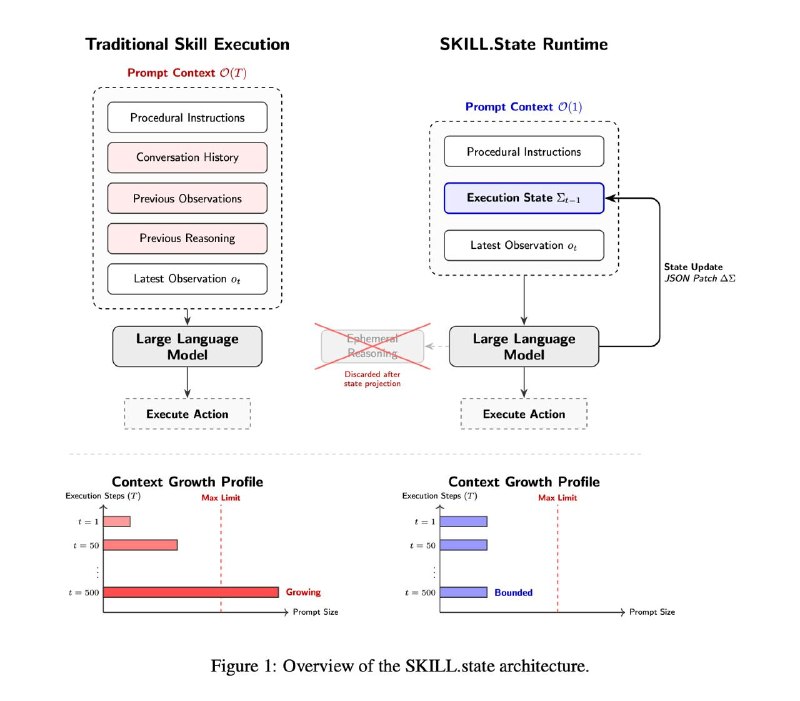
Авторы предлагают архитектуру SKILL.state: вместо накопления истории диалога – явное, изменяемое структурированное состояние выполнения.
Обычно агенты работают по принципу ReAct-стиля, то есть на каждом шаге модели заново скармливают весь накопленный диалог. Из-за этого промпт каждый раз растет линейно, а суммарное потребление токенов за весь запуск – квадратично. Плюс модель вынуждена каждый раз заново вычленять текущее состояние задачи из горы текста, что иногда провоцирует галлюцинации.
В статье предлагается вместо этого на каждом шаге отправлять модели явное изменяемое структурированное состояние выполнения (в статье это называется execution state). Как это работает:
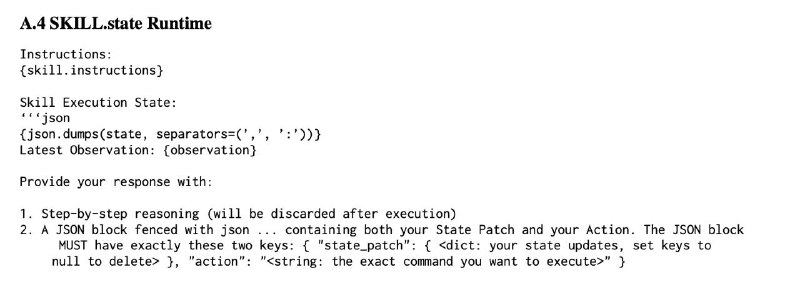
– На каждом шаге модель, помимо рассуждений, выдает JSON-блок с двумя полями: (1) конкретная команда, которую агент должен исполнить в среде; (2) state_patch – информация о том, что изменилось относительно прошлого состояния.
– Агент исполняет команду и получает ответ от среды, а в текущий state вносятся изменения в соответствие со state_patch.
– На следующий шаг передается: измененный state, системный промпт и последний ответ от среды. Никаких предыдущих сообщений, рассуждений модели с прошлых шагов и прочего.
Таким образом, размер промпта на каждом шаге становится константным, а суммарные затраты токенов растут линейно.
На синтетическом бенчмарке управления складом на 100 шагах SKILL.state экономит 93.8% токенов, на 200 шагах – 98%. Чем длиннее контекст, тем разрыв драматичнее.
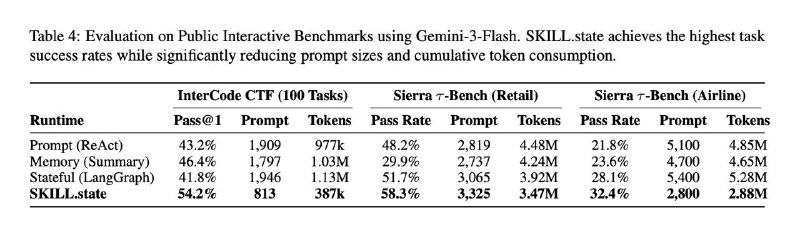
На реальных бенчмарках экономия чуть меньше, но при этом SKILL.state кое-где еще и выигрывает в точности. Например, на InterCode CTF выбивает 54.2% против 40-45% у бейзлайнов. Связано это с тем, что представление задачи через state получается более чистым и свободным от засоряющих фактов и неверных гипотез из прошлого контекста.
Это решение можно применить к любой, даже закрытой, модели, просто поменяв рантайм. В Appendix A приводится необходимый шаблон промпта, так что можно брать и пользоваться.
Почему это важно
АналитикаЭто новое решение позволяет значительно снизить затраты на токены, что критически важно для эффективности работы агентов. Оно также может повысить точность выполнения задач.
Обсудить в сообществе
Делитесь опытом и мыслями с ИИ-разработчиками
Связанные материалы экосистемы
Практические гайды, терминология и агентские скиллы
Gemini Flash & Pro (Google Gemini)
Семейство мультимодальных моделей от Google DeepMind, объединяющее рекордное контекстное окно (до 2 млн токенов), экстремальную скорость генерации (более 150 токенов/с) и нативное восприятие видео и аудио.
Google AI Studio: бесплатные API ключи Gemini
Официальная песочница Google: как получить бесплатный API ключ Gemini 2.0/1.5 без карты, настроить системные промты и 2M контекст. Лимиты и инструкция 2026.
Исследователи MIT показали, что GPT-6 Astra может улучшать другие ИИ-модели, изменяя их веса
В эксперименте Astra повысила точность Qwen3.5-0.8B на бенчмарке MATH-500 с 7,9% до 48,1%, изменив всего 0,016% весов модели.
Автономный AI-оператор в Telegram 24/7: архитектура, Telethon, безопасность и 10 рабочих сценариев
Исчерпывающее инженерное руководство по созданию production-ready AI-оператора в Telegram на базе Telethon: изоляция сессий, система подтверждений, защита от банов и запуск 24/7.