Google wprowadza architekturę SKILL.state, aby oszczędzać tokeny w sesjach agentów
Badacze z Google opracowali nową architekturę SKILL.state, która znacząco redukuje zużycie tokenów podczas pracy agentów AI poprzez zastąpienie historii dialogu jawnym stanem wykonania.
Google wprowadza architekturę SKILL.state, aby oszczędzać tokeny w sesjach agentów
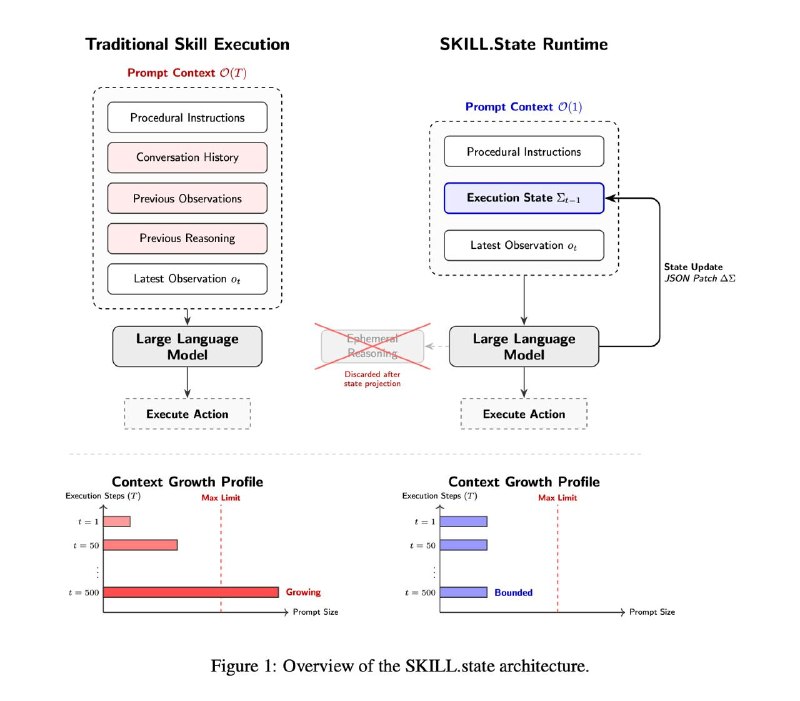
Autorzy proponują architekturę SKILL.state: zamiast akumulować historię dialogu, wykorzystuje ona jawny, modyfikowalny i ustrukturyzowany stan wykonania.
Zazwyczaj agenci działają na zasadzie typu ReAct, co oznacza, że na każdym kroku cały zgromadzony dotychczas dialog jest ponownie podawany do modelu. Powoduje to liniowy wzrost długości promptu przy każdym kroku, a całkowite zużycie tokenów dla całego przebiegu rośnie kwadratowo. Dodatkowo model musi za każdym razem wyodrębniać bieżący stan zadania z ogromnej ilości tekstu, co może czasem prowokować halucynacje.
Artykuł sugeruje zamiast tego przesyłanie do modelu na każdym kroku jawnego, modyfikowalnego stanu wykonania (w artykule nazywanego execution state). Oto jak to działa:
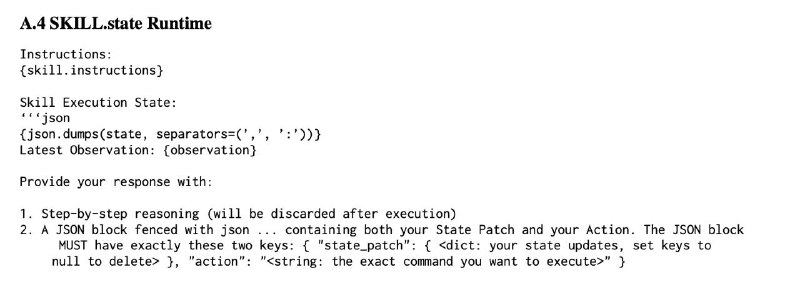
– Na każdym kroku model, oprócz wnioskowania, generuje blok JSON zawierający dwa pola: (1) konkretną komendę, którą agent musi wykonać w środowisku; (2) state_patch – informację o tym, co zmieniło się względem poprzedniego stanu.
– Agent wykonuje komendę i otrzymuje odpowiedź od środowiska, a następnie aktualny stan jest aktualizowany zgodnie z state_patch.
– Do następnego kroku przekazywane są tylko zaktualizowany stan, prompt systemowy oraz ostatnia odpowiedź ze środowiska. Nie ma wcześniejszych wiadomości, rozumowania modelu z przeszłych kroków ani żadnych innych danych.
W ten sposób rozmiar promptu na każdym kroku staje się stały, a całkowite koszty tokenów rosną liniowo.
W syntetycznym benchmarku zarządzania magazynem SKILL.state oszczędza 93,8% tokenów przy 100 krokach i 98% przy 200 krokach. Im dłuższy kontekst, tym bardziej dramatyczna różnica.
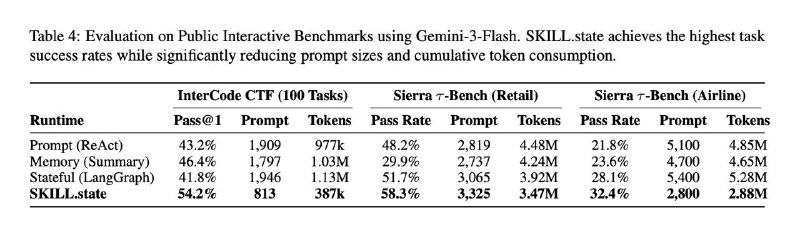
W rzeczywistych benchmarkach oszczędności są nieco mniejsze, ale SKILL.state bywa nawet skuteczniejszy pod względem dokładności. Na przykład w teście InterCode CTF osiąga wynik 54,2% w porównaniu do 40-45% dla rozwiązań bazowych. Wynika to z faktu, że reprezentacja zadania poprzez stan zapewnia czystszy i mniej zatłoczony widok, wolny od rozpraszających faktów i błędnych hipotez z przeszłych kontekstów.
To rozwiązanie można zastosować do dowolnego modelu, nawet zamkniętego, po prostu zmieniając środowisko uruchomieniowe (runtime). Aneks A zawiera niezbędny szablon promptu, dzięki czemu można go bezpośrednio wykorzystać.
Dlaczego to ważne
AnalizaTa nowa architektura znacząco obniża koszty operacyjne agentów AI poprzez redukcję zużycia tokenów, co jest kluczowe dla ich efektywności ekonomicznej. Jednocześnie może poprawić precyzję wykonywania zadań dzięki eliminacji szumów informacyjnych.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami