Google presenta la arquitectura SKILL.state para ahorrar tokens en sesiones con agentes
Investigadores de Google han desarrollado una nueva arquitectura, SKILL.state, que reduce significativamente el consumo de tokens durante las operaciones de los agentes.
Google presenta la arquitectura SKILL.state para ahorrar tokens en sesiones con agentes
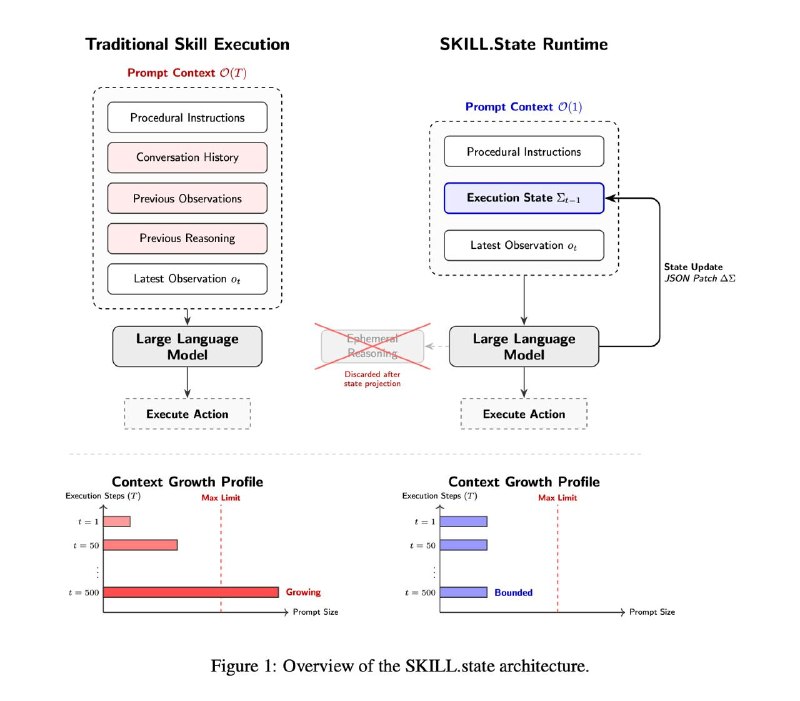
Los autores proponen la arquitectura SKILL.state: en lugar de acumular el historial de diálogos, utiliza un estado de ejecución estructurado explícito y mutable.
Normalmente, los agentes operan bajo un principio de estilo ReAct, lo que significa que en cada paso, se vuelve a alimentar al modelo con todo el diálogo acumulado. Esto provoca que el prompt crezca linealmente cada vez, mientras que el consumo total de tokens para toda la ejecución crece cuadráticamente. Además, el modelo se ve obligado a extraer el estado actual de la tarea de una montaña de texto cada vez, lo que a veces puede provocar alucinaciones.
El artículo sugiere en su lugar enviar al modelo un estado de ejecución estructurado explícito y mutable (denominado estado de ejecución en el artículo) en cada paso. Así es como funciona:
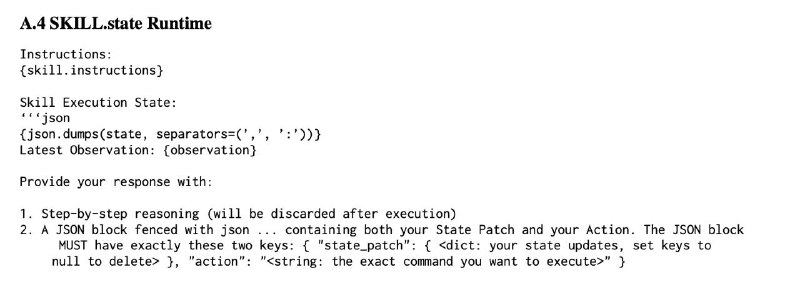
– En cada paso, el modelo, además de razonar, emite un bloque JSON con dos campos: (1) un comando específico que el agente debe ejecutar en el entorno; (2) state_patch – información sobre lo que ha cambiado en relación con el estado anterior.
– El agente ejecuta el comando y recibe una respuesta del entorno, y el estado actual se actualiza de acuerdo con el state_patch.
– Para el siguiente paso, se pasa el estado actualizado, el prompt del sistema y la última respuesta del entorno. No hay mensajes anteriores, razonamientos del modelo de pasos anteriores ni nada más.
Así, el tamaño del prompt en cada paso se vuelve constante, y los costos totales de tokens crecen linealmente.
En un benchmark sintético de gestión de almacenes, SKILL.state ahorra un 93.8% de tokens en 100 pasos, y un 98% en 200 pasos. Cuanto más largo es el contexto, más dramática es la diferencia.
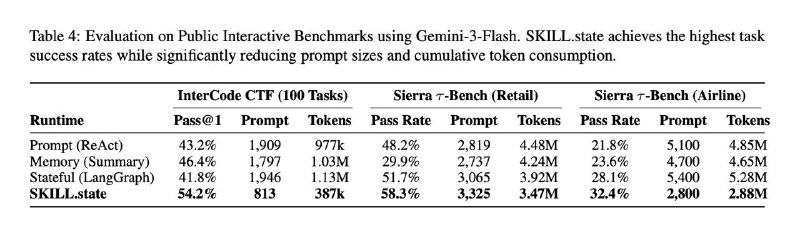
En benchmarks reales, el ahorro es un poco menor, pero SKILL.state a veces también gana en precisión. Por ejemplo, en el InterCode CTF, logra un 54.2% en comparación con el 40-45% de las líneas base. Esto se debe a que la representación de la tarea a través del estado resulta ser más limpia y libre de hechos distractores e hipótesis incorrectas del contexto anterior.
Esta solución se puede aplicar a cualquier modelo, incluso a los cerrados, simplemente cambiando el tiempo de ejecución. El Apéndice A proporciona la plantilla de prompt necesaria, por lo que se puede tomar y utilizar.
Por qué es importante
AnálisisEsta nueva arquitectura reduce significativamente los costos de tokens, lo cual es crítico para la eficiencia de las operaciones de los agentes. También puede mejorar la precisión en la ejecución de tareas.
Debatir en la comunidad
Comparte tus preguntas e ideas con desarrolladores
Relacionado en el ecosistema
Guías prácticas, terminología y skills de agentes
JSON — Datos estructurados para programas, APIs y agentes de IA
Guía práctica y completa sobre JSON: especificación de sintaxis, serialización con parse y stringify, consumo de APIs REST, validación con JSON Schema y salidas estructuradas para LLMs.
Operador de IA autónomo en Telegram 24/7: arquitectura, Telethon, seguridad y 10 casos de uso
Guía técnica exhaustiva para desarrollar un operador de IA listo para producción en Telegram basado en Telethon: aislamiento de sesiones, sistema de confirmaciones, protección contra baneos y ejecución continua 24/7.
Memoria a Corto y Largo Plazo de Agentes
Arquitectura de memoria multinivel para agentes autónomos. Se divide en memoria a corto plazo (Short-Term Memory — ventana de contexto activa de la sesión actual) y memoria a largo plazo (Long-Term Memory — bases de datos vectoriales, archivos de perfil de usuario y diarios episódicos).
Gemini Flash & Pro (Google Gemini)
Familia de modelos multimodales de Google DeepMind que combina una ventana de contexto récord (hasta 2 millones de tokens), velocidad de generación extrema (más de 150 tokens/s) y percepción nativa de video y audio.