Google представив архітектуру SKILL.state для економії токенів на сесіях з агентами
Дослідники з Google розробили нову архітектуру SKILL.state, яка дозволяє значно зменшити споживання токенів під час роботи з агентами.
Дослідники з Google знайшли спосіб економити до 98% токенів на довгих сесіях з агентами
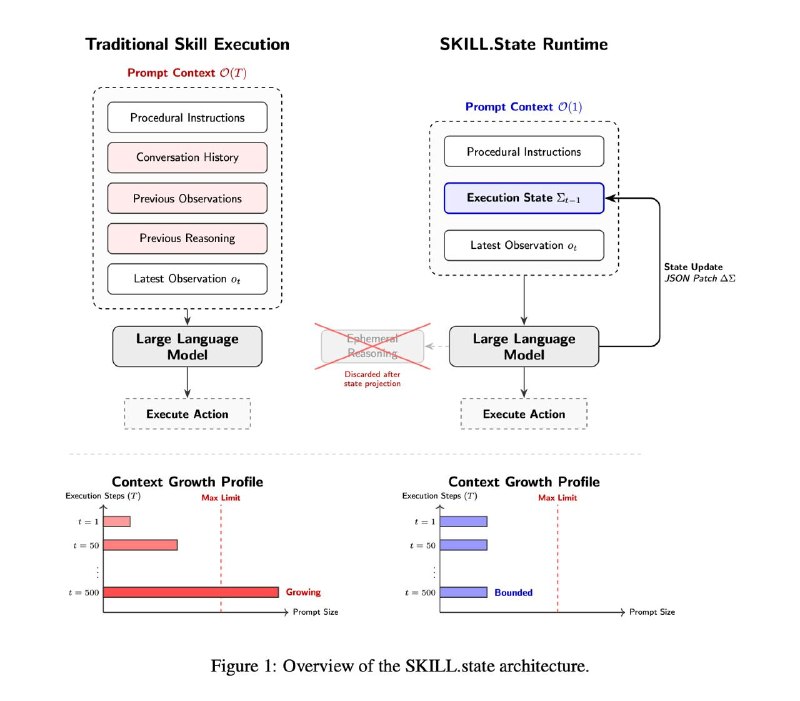
Авторам пропонується архітектура SKILL.state: замість накопичення історії діалогу – явне, змінюване структуроване стан виконання.
Зазвичай агенти працюють за принципом ReAct-стилю, тобто на кожному кроці моделі знову подають весь накопичений діалог. Через це промпт кожного разу зростає лінійно, а загальне споживання токенів за весь запуск – квадратично. Крім того, модель змушена кожного разу знову виділяти поточний стан задачі з купи тексту, що іноді провокує галюцинації.
У статті пропонується замість цього на кожному кроці надсилати моделям явне змінюване структуроване стан виконання (в статті це називається execution state). Як це працює:
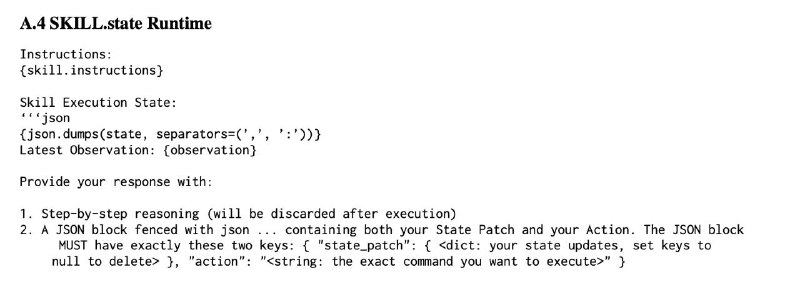
– На кожному кроці модель, окрім міркувань, видає JSON-блок з двома полями: (1) конкретна команда, яку агент має виконати в середовищі; (2) state_patch – інформація про те, що змінилося відносно попереднього стану.
– Агент виконує команду та отримує відповідь від середовища, а в поточний стан вносяться зміни відповідно до state_patch.
– На наступний крок передається: змінений стан, системний промпт та остання відповідь від середовища. Жодних попередніх повідомлень, міркувань моделі з минулих кроків та іншого.
Таким чином, розмір промпта на кожному кроці стає константним, а загальні витрати токенів зростають лінійно.
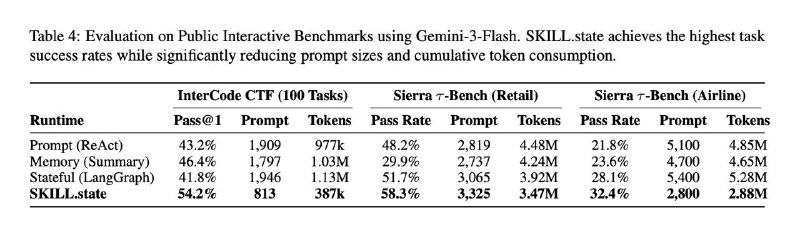
На синтетичному бенчмарку управління складом на 100 кроках SKILL.state економить 93.8% токенів, на 200 кроках – 98%. Чим довший контекст, тим розрив драматичніший.
На реальних бенчмарках економія трохи менша, але при цьому SKILL.state в деяких випадках ще й виграє в точності. Наприклад, на InterCode CTF показує 54.2% проти 40-45% у базових моделях. Це пов'язано з тим, що представлення задачі через state є більш чистим і вільним від зашумлених фактів та неправильних гіпотез з минулого контексту.
Це рішення можна застосувати до будь-якої, навіть закритої, моделі, просто змінивши рантайм. В Appendix A наводиться необхідний шаблон промпта, так що можна брати і користуватися.
Чому це важливо
АналітикаЦя нова архітектура дозволяє значно зменшити витрати на токени, що є критично важливим для ефективності роботи агентів. Вона також може підвищити точність виконання завдань.
Обговорити новину у спільноті
Діліться своїм досвідом та думками з ШІ-розробниками
Пов'язані матеріали екосистеми
Практичні гайди, термінологія та агентські скіли
Gemini Flash & Pro (Google Gemini)
Сімейство мультимодальних моделей від Google DeepMind, що поєднує рекордне контекстне вікно (до 2 млн токенів), екстремальну швидкість генерації (понад 150 токенів/с) та нативне сприйняття відео й аудіо.
Google AI Studio: безкоштовні API ключі Gemini
Офіційна пісочниця Google: як отримати безкоштовний API-ключ Gemini без банківської карти, налаштувати системні промпти та ліміти 2M контексту.
Автономний AI-оператор у Telegram 24/7: архітектура, Telethon, безпека та 10 робочих сценаріїв
Вичерпне інженерне керівництво зі створення production-ready AI-оператора в Telegram на базі Telethon: ізоляція сесій, система підтверджень, захист від банів та запуск 24/7.
Loop Engineering: архітектура автономних петель та завершення ери ручного промптингу
Глибоке занурення в Loop Engineering: архітектура самопідтримуваних циклів для Claude Code та автономних агентів, шаблон DOER/CHECKER, детермінована верифікація, команда /goal та боротьба з Reward Hacking.