KI-Modell-Tierlist: Kann echte bezahlte Nutzung offizielle Benchmarks schlagen?
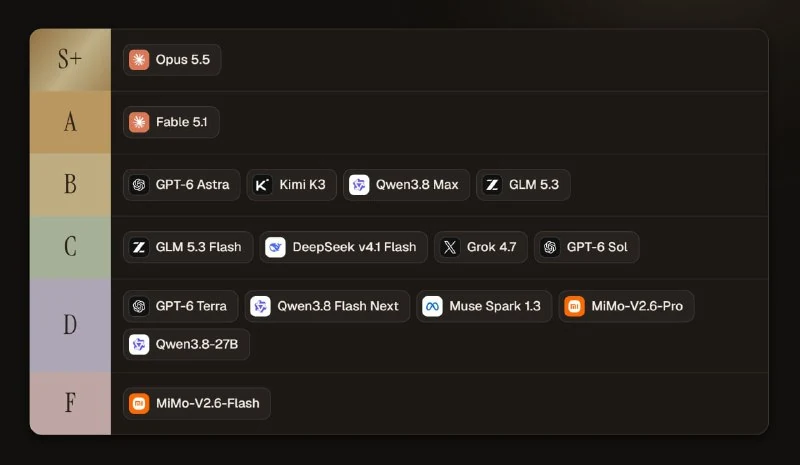
Eine im Umlauf befindliche Tierlist für KI-Modelle, basierend auf realer bezahlter Nutzung, könnte genauer sein als die meisten offiziellen Benchmarks.
KI-Modell-Tierlist: Kann echte bezahlte Nutzung offizielle Benchmarks schlagen?
Im Internet kursiert derzeit eine Tierlist für KI-Modelle, die möglicherweise präziser ist als die meisten offiziellen Benchmark-Ergebnisse.
Der entscheidende Unterschied liegt darin, dass diese Rangliste nicht auf synthetischen Testaufgaben basiert, sondern auf der tatsächlichen Nutzung mit bezahlten Workloads. Das bedeutet, dass die Platzierungen nicht nur durch künstliche Metriken bestimmt werden, sondern auch durch praktischen Nutzen, Kosten und direkte Erfahrungswerte.
Dies wirft die naheliegende Frage auf: Ist die reale bezahlte Nutzung ein besserer Indikator für die Qualität von KI-Modellen als Standard-Benchmarks?
Warum das wichtig ist
AnalyseEchte bezahlte Nutzung kann Stärken offenbaren, die in synthetischen Tests untergehen, ist jedoch schwerer zu reproduzieren und stark von spezifischen Arbeitsabläufen abhängig.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern
Verwandt im Ökosystem
Praktische Leitfäden, Terminologie und Agenten-Skills
Qwen4-Max veröffentlicht: 50 % weniger Tokens und niedrigere Kosten pro Aufgabe
Qwen4-Max bringt eine MoE-Architektur, ein 1-Million-Tokens-Kontextfenster, integrierte Bildunterstützung und deutlich geringere Kosten.
Teil II. Architektur von KI-Agenten: Vom Modell zu Gedächtnis und Tools
Tiefes technisches Eintauchen: Tokenisierung, KV-Cache, Determinismus beim Sampling, Trainings-Stack, Quantisierung, Kontext-Engineering, Security-Stack, produktives RAG, ReAct sowie Multi-Agenten-Swarm-Systeme.
Claude Sonnet 4.6 vs GPT-5.5 vs Gemini 3.1 Pro: Modellvergleich 2026
Alle paar Wochen erscheint ein neues Modell, und jedes Mal stellen sich dieselben Fragen: Lohnt sich der Wechsel? Was hat sich geändert? Wofür lohnt sich die Investition?
Agenten-Benchmarks: GAIA und SWE-bench
Eine neue Generation strenger praktischer Benchmarks zur Bewertung der Autonomie von Künstlicher Intelligenz. GAIA testet multimodale Aufgaben im offenen Web mit Dateien und Browser, während SWE-bench die Fähigkeit von Agenten überprüft, echte Bugs in großen GitHub-Repositories zu finden und zu beheben.