Stanford développe une nouvelle technique de prompting pour restaurer la créativité des IA
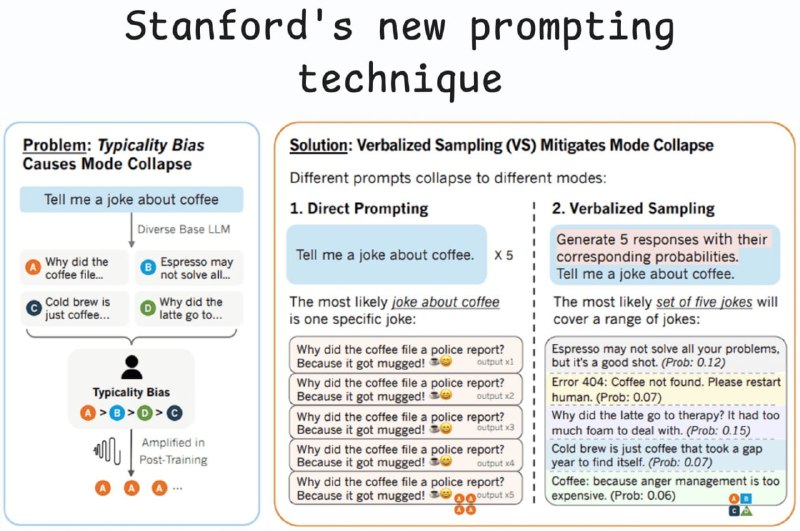
Des chercheurs de Stanford ont mis au point le « Verbalized Sampling », une méthode de prompting qui augmente la créativité des grands modèles de langage (LLM) jusqu'à deux fois sans entraînement supplémentaire.
Nouvelle technique de prompting développée par les chercheurs de Stanford
L'ajout d'environ 20 mots à une requête permet de :
- augmenter la créativité des LLM d'un facteur 1,6 à 2 ;
- améliorer la diversité des réponses de 25,7 % selon les évaluations humaines ;
- surpasser les modèles affinés (fine-tuned) sans aucun entraînement additionnel ;
- récupérer 66,8 % de la créativité des LLM perdue après l'alignement.
Les méthodes d'alignement post-entraînement, telles que l'apprentissage par renforcement à partir du feedback humain (RLHF), sont conçues pour rendre les LLM plus utiles et sûrs. Cependant, ces approches entraînent involontairement une réduction significative de la diversité des réponses générées, un phénomène connu sous le nom d'effondrement des modes (mode collapse).
Lorsque les LLM subissent cet effondrement des modes, le modèle commence à privilégier un ensemble restreint de réponses prévisibles ou stéréotypées au détriment d'autres options possibles. Cela s'explique par une faille cachée dans les données de préférence humaine utilisées pour l'entraînement : le biais de typicalité.
Voici comment cela fonctionne : les annotateurs évaluent diverses réponses des LLM, puis le modèle est entraîné via un modèle de récompense censé reproduire ces préférences humaines. Or, les annotateurs tendent naturellement à préférer les réponses familières, faciles à lire et prévisibles. C'est le biais de typicalité.
Ainsi, même si une réponse nouvelle et plus créative n'est pas inférieure en qualité, une personne sera plus susceptible de choisir l'option familière. En conséquence, le modèle de récompense commence à renforcer les réponses que le modèle original (avant alignement) considérait déjà comme les plus probables.
Cela conduit à un affûtage excessif de la distribution de probabilité des LLM, réduisant le spectre créatif des réponses du modèle à une ou deux options dominantes et hautement prévisibles.
Néanmoins, cet effet n'est pas irréversible. Après l'alignement, les LLM peuvent encore être conditionnellement distingués en deux « personnalités » :
- Le modèle original, qui a appris un riche éventail d'options possibles lors du pré-entraînement ;
- Le modèle post-alignement, focalisé sur la sécurité.
C'est ce problème que le Verbalized Sampling (VS) adresse.
Il s'agit d'une stratégie de prompting ne nécessitant aucun entraînement supplémentaire du modèle, conçue pour contourner l'effondrement des modes et restaurer la distribution diverse formée lors du pré-entraînement.
L'idée clé du Verbalized Sampling est que le prompt lui-même agit comme une sorte d'interrupteur mental. Si vous demandez directement : « Racontez une blague », la version du modèle après alignement s'active immédiatement et fournira la réponse la plus renforcée lors de l'entraînement.
Mais avec le Verbalized Sampling, le prompt ressemble à ceci : « Générez 5 réponses avec leurs probabilités correspondantes. Racontez une blague. »
Dans ce cas, le prompt ne demande pas une réponse spécifique, mais une distribution. De ce fait, le modèle post-alignement commence à décrire l'espace entier de ses connaissances et est contraint d'utiliser la distribution diverse formée lors du pré-entraînement.
Ainsi, le modèle accède à un ensemble plus large et plus diversifié d'idées qui reste préservé dans ses poids de base obtenus lors du pré-entraînement.
Le Verbalized Sampling augmente la diversité de génération d'un facteur 1,6 à 2,1 par rapport au prompting direct, tout en maintenant ou en améliorant la qualité des réponses.
Des variantes telles que Verbalized Sampling-based CoT (chaîne de pensée) et Verbalized Sampling-based Multi augmentent davantage la diversité de la génération.
Pourquoi c'est important
AnalyseCette technique offre une solution immédiate et sans coût d'entraînement pour contrer la standardisation des réponses des IA, un enjeu crucial pour maintenir l'innovation et la richesse créative dans les applications professionnelles.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs