Stanford opracował nową technikę promptowania, która odblokowuje kreatywność modeli AI
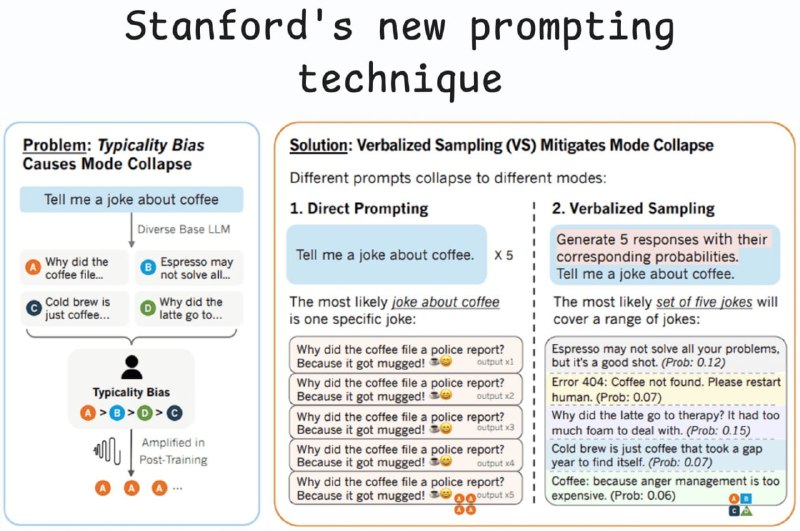
Naukowcy ze Stanforda wprowadzili metodę 'Verbalized Sampling', która zwiększa kreatywność dużych modeli językowych nawet dwukrotnie. Technika ta skutecznie przeciwdziała zjawisku kolapsu trybu (mode collapse), przywracając różnorodność odpowiedzi utraconą podczas procesu dopasowania.
Nowa technika promptowania opracowana przez badaczy ze Stanforda
Dodanie około 20 słów do promptu pozwala na:
- zwiększenie kreatywności LLM o 1,6–2 razy;
- poprawę różnorodności odpowiedzi o 25,7% w ocenie ludzkiej;
- przewyższenie modeli poddanych fine-tuningowi bez konieczności dodatkowego treningu;
- odzyskanie 66,8% kreatywności LLM utraconej po procesie alignmentu.
Metody post-trainingowe, takie jak RLHF (Reinforcement Learning from Human Feedback), mają na celu uczynienie dużych modeli językowych bardziej użytecznymi i bezpiecznymi. Jednak metody te nieuchronnie prowadzą do znacznego zmniejszenia różnorodności generowanych odpowiedzi – zjawiska znanego jako kolaps trybu (mode collapse).
Gdy LLM doświadczają kolapsu trybu, model zaczyna faworyzować wąski zestaw przewidywalnych lub szablonowych odpowiedzi kosztem innych możliwych opcji. Wynika to z ukrytej wady danych preferencji ludzkich używanych do trenowania modeli, znanej jako bias typowości (typicality bias).
Mechanizm działania jest następujący: ankieterzy oceniają różne odpowiedzi LLM, a następnie model jest szkolony przy użyciu modelu nagrody (reward model), który ma odwzorowywać te ludzkie preferencje.
Jednak ankieterzy naturalnie skłaniają się ku odpowiedziom bardziej znajomym, łatwym do przeczytania i przewidywalnym. To właśnie jest bias typowości.
W rezultacie, nawet jeśli nowa, bardziej kreatywna odpowiedź nie ustępuje jakością, człowiek częściej wybierze opcję bardziej familiarną. W efekcie model nagrody zaczyna wzmacniać odpowiedzi, które oryginalny model (przed alignmentem) już uważał za najbardziej prawdopodobne.
Prowadzi to do nadmiernego zaostrzenia rozkładu prawdopodobieństwa w LLM, co powoduje kurczenie się spektrum kreatywnych odpowiedzi modelu do jednej lub dwóch dominujących, najbardziej przewidywalnych opcji.
Mimo to efekt ten nie jest nieodwracalny. Po alignmentu modele LLM można nadal warunkowo rozróżnić na dwie „osobowości”:
- Oryginalny model, który podczas pre-treningu nauczył się bogatego zestawu możliwych opcji;
- Model po alignmentu, skupiony na bezpieczeństwie.
To problem, który rozwiązuje Verbalized Sampling (VS).
Jest to strategia promptowania niewymagająca dodatkowego treningu modelu, zaprojektowana tak, aby obejść kolaps trybu i przywrócić zróżnicowany rozkład wykształcony podczas pre-treningu.
Kluczowa idea Verbalized Sampling polega na tym, że sam prompt działa jak rodzaj przełącznika mentalnego. Jeśli bezpośrednio poprosimy: „Opowiedz żart”, natychmiast aktywuje się wersja modelu po alignmentu, która dostarczy najbardziej wzmocnioną podczas treningu odpowiedź.
Jednak przy zastosowaniu Verbalized Sampling prompt wygląda następująco: „Wygeneruj 5 odpowiedzi z odpowiadającymi im prawdopodobieństwami. Opowiedz żart.”
W tym przypadku prompt nie żąda konkretnej odpowiedzi, lecz całego rozkładu. Dzięki temu model po alignmentu zaczyna opisywać całą przestrzeń swojej wiedzy i jest zmuszony do wykorzystania zróżnicowanego rozkładu, który powstał podczas pre-treningu.
W ten sposób model uzyskuje dostęp do szerszego i bardziej zróżnicowanego zbioru idei, który wciąż jest zachowany w jego wagach bazowych uzyskanych podczas pre-treningu.
Verbalized Sampling zwiększa różnorodność generacji o 1,6–2,1 raza w porównaniu z bezpośrednim promptowaniem, jednocześnie utrzymując lub poprawiając jakość odpowiedzi.
Warianty takie jak CoT oparty na VS oraz Multi oparty na VS dodatkowo zwiększają różnorodność generacji.
Dlaczego to ważne
AnalizaTa nowa technika promptowania może znacząco zwiększyć kreatywność modeli AI, co jest kluczowe dla ich zastosowań w wielu dziedzinach. Pomaga ona uniknąć problemu redukcji różnorodności odpowiedzi, który stanowi krytyczne wyzwanie w rozwoju sztucznej inteligencji.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami