Nova técnica de prompting desenvolvida por pesquisadores de Stanford
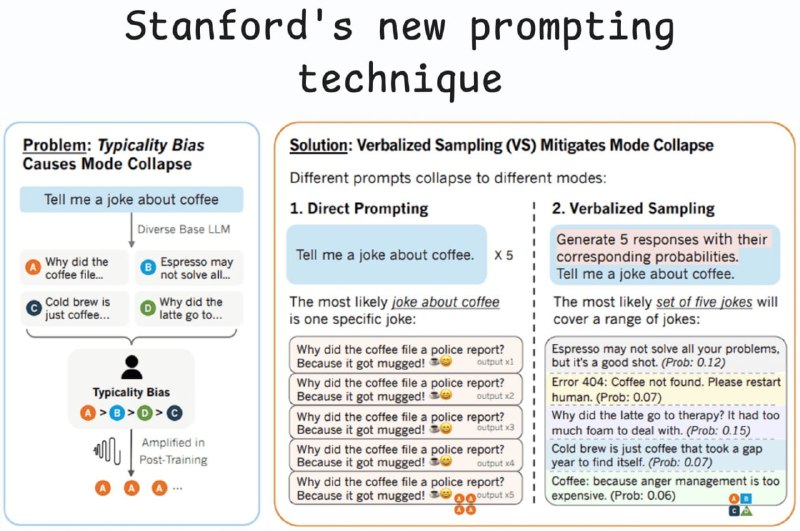
Pesquisadores de Stanford introduziram uma nova técnica de prompting que aumenta a criatividade dos modelos de IA e aborda a questão da redução na diversidade das respostas.
Nova técnica de prompting desenvolvida por pesquisadores de Stanford
Adicionar aproximadamente 20 palavras a um prompt permite:
- Aumentar a criatividade dos LLMs em 1,6 a 2 vezes;
- Melhorar a diversidade das respostas em 25,7% segundo avaliações humanas;
- Superar modelos ajustados (fine-tuned) sem treinamento adicional;
- Recuperar 66,8% da criatividade dos LLMs perdida após o alinhamento.
Métodos de alinhamento pós-treinamento, como RLHF, são projetados para tornar os LLMs mais úteis e seguros. No entanto, esses métodos levam inadvertidamente a uma redução significativa na diversidade das respostas geradas (um fenômeno conhecido como colapso de modo).
Quando os LLMs experimentam o colapso de modo, o modelo começa a favorecer um conjunto estreito de respostas previsíveis ou do tipo template sobre outras opções possíveis. Isso ocorre porque os dados de preferência humana usados para treinar os LLMs contêm uma falha oculta conhecida como viés de tipicidade.
Veja como funciona: Anotadores avaliam várias respostas dos LLMs, após o que o modelo é treinado usando um modelo de recompensa que deve reproduzir essas preferências humanas.
No entanto, os anotadores tendem naturalmente a preferir respostas mais familiares, legíveis e previsíveis. Este é o viés de tipicidade.
Assim, mesmo que uma resposta nova e mais criativa não seja inferior em qualidade, uma pessoa tem maior probabilidade de escolher a opção mais familiar. Como resultado, o modelo de recompensa começa a reforçar respostas que o modelo original (antes do alinhamento) já considerava as mais prováveis.
Isso leva a um afunilamento excessivo da distribuição de probabilidade dos LLMs, fazendo com que o espectro criativo das respostas do modelo se reduza a uma ou duas opções dominantes e mais previsíveis.
No entanto, esse efeito não é irreversível, e após o alinhamento, os LLMs ainda podem ser condicionalmente distinguidos em duas "personalidades":
- O modelo original, que durante o pré-treinamento aprendeu um rico conjunto de opções possíveis;
- O modelo pós-alinhamento, focado na segurança.
Este é o problema que o Verbalized Sampling (VS) aborda.
É uma estratégia de prompting que não requer treinamento adicional do modelo, projetada para contornar o colapso de modo e restaurar a distribuição diversa formada durante o pré-treinamento.
A ideia-chave do Verbalized Sampling é que o próprio prompt atua como uma espécie de interruptor mental. Se você perguntar diretamente: "Conte uma piada", a versão do modelo após o alinhamento será ativada imediatamente, fornecendo a resposta mais reforçada durante o treinamento.
Mas ao usar o Verbalized Sampling, o prompt fica assim: "Gere 5 respostas com probabilidades correspondentes. Conte uma piada."
Neste caso, o prompt solicita não uma resposta específica, mas uma distribuição. Por causa disso, o modelo pós-alinhamento começa a descrever todo o espaço de seu conhecimento e é forçado a usar a distribuição diversa que foi formada durante o pré-treinamento.
Assim, o modelo acessa um conjunto mais amplo e diverso de ideias que ainda está preservado em seus pesos base obtidos durante o pré-treinamento.
O Verbalized Sampling aumenta a diversidade da geração em 1,6 a 2,1 vezes em comparação com o prompting direto, mantendo ou melhorando a qualidade das respostas.
Variantes como CoT baseado em Verbalized Sampling e Multi baseado em Verbalized Sampling aumentam ainda mais a diversidade da geração.
Por que isso importa
AnáliseEsta nova técnica de prompting pode melhorar significativamente a criatividade dos modelos de IA, crucial para sua aplicação em diversos campos. Ela ajuda a evitar o problema da redução na diversidade das respostas, essencial para o desenvolvimento da IA.
Debater na comunidade
Compartilhe suas dúvidas e insights com desenvolvedores