Difusão Mascarada em Forma de Estrela Guiada
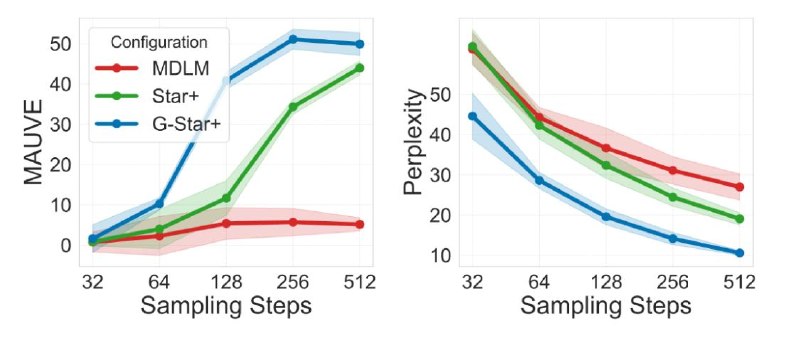
Um novo método de difusão mascarada em forma de estrela guiada melhora significativamente a qualidade da geração de texto sem sacrificar a velocidade. A abordagem inovadora otimiza o tratamento do mascaramento de tokens e a correção de erros.
Difusão Mascarada em Forma de Estrela Guiada
Nos modelos de linguagem (LLMs) baseados em difusão mascarada, existe um problema fundamental: uma vez que um token é desmascarado, ele fica congelado. Se o modelo cometer um erro numa etapa inicial, não consegue corrigi-lo e tenta construir o texto à volta desse erro. Essas inconsistências são particularmente notórias quando se utiliza um número reduzido de etapas. Os métodos existentes de remascaramento permitem ao modelo reconsiderar as suas escolhas, mas exigem centenas de etapas, o que compromete a principal vantagem da difusão: a velocidade.
Autores da T-Tech, HSE e Constructor University apresentaram no ICML um método onde todos os estados ruidosos dependem apenas do texto limpo, e não entre si. Em cada etapa, o modelo prevê a sequência completa limpa, e o próximo estado é reamostrado a partir dela, sem herdar nada do estado atual: qualquer token pode ser devolvido ao estado mascarado e reescrito, sem necessidade de retreino. No entanto, gerar do zero não é viável — o remascaramento nas primeiras etapas destrói o contexto ainda em formação. Por isso, os primeiros ~70% das etapas são executados da maneira usual, ativando-se o modo de edição apenas posteriormente. O local para editar é indicado por um preditor de erros leve e separado, treinado nos erros do modelo durante a geração. A principal limitação desta abordagem é a incapacidade de inserir ou apagar tokens.
Como resultado, em 128 etapas, o método supera a qualidade e a diversidade de texto das melhores abordagens anteriores com um orçamento de 512 etapas, permitindo uma geração quase três vezes mais rápida (3,4 segundos vs. 9,2 segundos na H200). O preditor de erros, treinado em textos da web, transfere-se eficazmente para código, matemática e notícias sem necessidade de retreino.
Por que isso importa
AnáliseEste método aumenta drasticamente a eficiência da geração de texto, sendo crucial para o desenvolvimento de novas aplicações de IA. A combinação de velocidade e qualidade abre novas possibilidades para a utilização de LLMs em diversos setores.
Debater na comunidade
Compartilhe suas dúvidas e insights com desenvolvedores