Geführte sternförmige Maskierte Diffusion
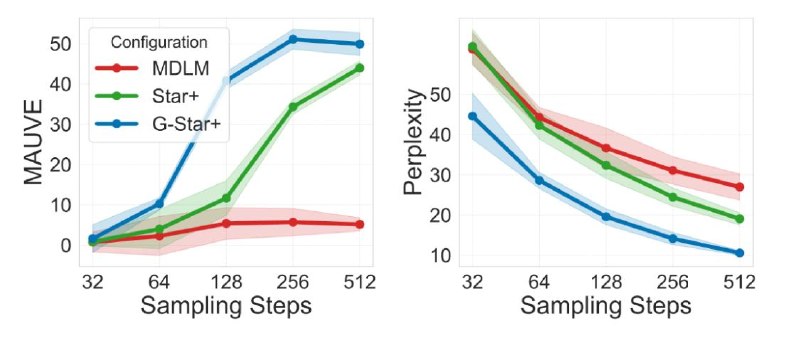
Ein neues Verfahren der geführten sternförmigen maskierten Diffusion verbessert die Textgenerierungsqualität erheblich, ohne die Geschwindigkeit zu opfern. Dieser innovative Ansatz ermöglicht eine effizientere Handhabung von Token-Maskierung und Fehlerkorrektur.
Geführte sternförmige Maskierte Diffusion
In maskierten Diffusions-LLMs besteht ein gravierendes Problem: Sobald ein Token entmaskiert wurde, ist es eingefroren. Wenn das Modell in einem frühen Schritt einen Fehler macht, kann es diesen nicht korrigieren, sondern versucht stattdessen, den Text um den Fehler herum aufzubauen. Solche Inkonsistenzen sind besonders bei einer geringen Anzahl von Schritten auffällig. Bestehende Remasking-Methoden geben dem Modell die Möglichkeit zur Überarbeitung, erfordern jedoch Hunderte von Schritten, was den Hauptvorteil der Diffusion – die Geschwindigkeit – untergräbt.
Autoren von T-Tech, HSE und der Constructor University präsentierten auf der ICML eine Methode, bei der alle verrauschten Zustände nur vom sauberen Text abhängen und nicht voneinander. In jedem Schritt sagt das Modell die gesamte saubere Sequenz voraus, und der nächste Zustand wird daraus neu abgetastet, ohne etwas vom aktuellen Zustand zu übernehmen: Jedes Token kann zurück zum Maskenzustand gesetzt und neu geschrieben werden, ohne dass ein Retraining erforderlich ist. Eine Generierung von Grund auf ist nicht möglich – das Remasking in frühen Schritten zerstört den noch nicht geformten Kontext. Daher werden die ersten ~70 % der Schritte wie üblich geschrieben, und erst danach wird der Bearbeitungsmodus aktiviert. Wo bearbeitet werden soll, zeigt ein separates leichtgewichtiges Fehlerprädiktionsmodell an, das auf den Fehlern des Modells während der Generierung trainiert wurde. Der wesentliche Nachteil dieses Ansatzes ist die Unfähigkeit, Tokens einzufügen oder zu löschen.
Das Ergebnis: In 128 Schritten übertrifft die Methode die Qualität und Diversität des Textes der besten bisherigen Ansätze mit einem Budget von 512 Schritten. Dies ermöglicht eine nahezu dreimal schnellere Generierung (3,4 vs. 9,2 Sekunden auf H200). Das auf Webtexten trainierte Fehlerprädiktionsmodell überträgt sich ohne Retraining auf Code, Mathematik und Nachrichten.
Warum das wichtig ist
AnalyseDiese Methode steigert die Effizienz der Textgenerierung erheblich, was für die Entwicklung neuer KI-Anwendungen entscheidend sein kann. Die Kombination aus hoher Geschwindigkeit und verbesserter Qualität eröffnet neue Möglichkeiten für den Einsatz von LLMs in verschiedenen Branchen.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern