Diffusion masquée guidée en étoile : une avancée majeure pour la génération de texte
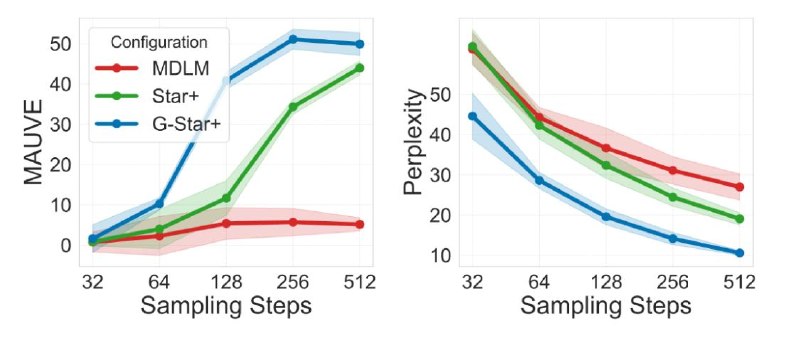
Une nouvelle méthode de diffusion masquée améliore considérablement la qualité du texte tout en préservant la rapidité, grâce à un mécanisme innovant de correction d'erreurs.
Diffusion masquée guidée en étoile
Dans les grands modèles de langage (LLM) basés sur la diffusion masquée, un problème fondamental persiste : une fois qu'un jeton est démasqué, il est figé. Si le modèle commet une erreur lors d'une étape précoce, il ne peut pas la corriger et tente plutôt de construire le texte autour de cette incohérence. Ces anomalies sont particulièrement visibles lorsque le nombre d'étapes est faible. Les méthodes existantes de remasquage offrent au modèle la possibilité de reconsidérer ses choix, mais elles nécessitent des centaines d'étapes, ce qui annule l'avantage principal de la diffusion : la vitesse.
Des chercheurs de T-Tech, HSE et Constructor University ont présenté une méthode lors de la conférence ICML où tous les états bruités dépendent uniquement du texte propre, et non les uns des autres. À chaque étape, le modèle prédit l'intégralité de la séquence propre, et l'état suivant est rééchantillonné à partir de celle-ci, sans hériter rien de l'état actuel : n'importe quel jeton peut être remis sous masque et réécrit, sans nécessiter de réentraînement. La génération complète depuis zéro n'est pas possible — le remasquage aux premières étapes détruit le contexte encore informe. Ainsi, les ~70 % premières étapes suivent le processus habituel, avant que le mode édition ne soit activé. L'emplacement des corrections est indiqué par un prédicteur d'erreur léger, entraîné spécifiquement sur les erreurs commises par le modèle durant la génération. Le principal inconvénient de cette approche reste l'impossibilité d'insérer ou de supprimer des jetons.
En conséquence, en 128 étapes seulement, cette méthode surpasses la qualité et la diversité textuelle des meilleures approches précédentes utilisant un budget de 512 étapes. Elle permet une génération près de trois fois plus rapide (3,4 secondes contre 9,2 secondes sur GPU H200). De plus, le prédicteur d'erreur entraîné sur des textes web se transfère efficacement au code, aux mathématiques et aux actualités sans réentraînement supplémentaire.
Pourquoi c'est important
AnalyseCette méthode optimise radicalement l'efficacité de la génération de texte, ouvrant la voie à des applications IA plus rapides et fiables dans divers secteurs critiques.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs