Stanford-Forscher entwickeln neue Prompting-Technik zur Steigerung der KI-Kreativität
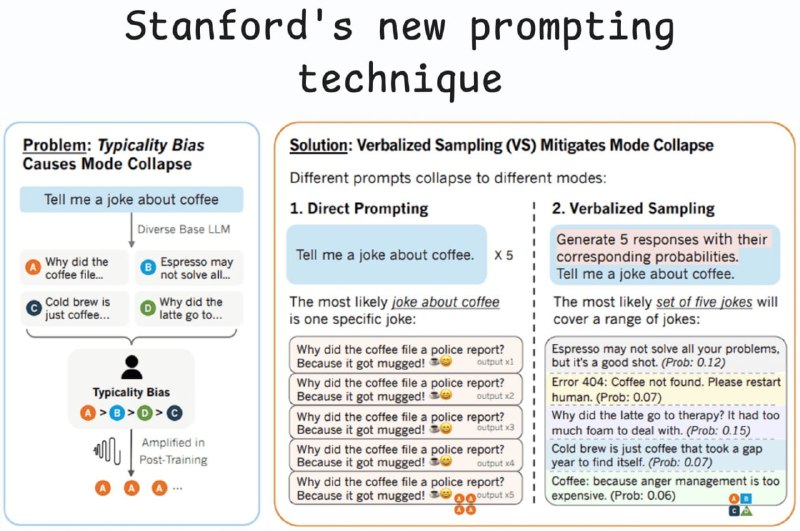
Forschende der Stanford University haben mit 'Verbalized Sampling' eine Methode vorgestellt, die die Kreativität von Large Language Models (LLMs) um das 1,6- bis 2-fache steigert. Der Ansatz löst das Problem der durch Alignment verursachten Modus-Kollaps-Effekte, ohne dass zusätzliche Trainingsphasen nötig sind.
Neue Prompting-Technik von Stanford-Forschern entwickelt
Die Hinzufügung von nur etwa 20 Wörtern zu einem Prompt ermöglicht:
- eine Steigerung der Kreativität von LLMs um das 1,6- bis 2-fache;
- eine Verbesserung der Antwortvielfalt um 25,7 % gemäß menschlichen Bewertungen;
- eine Überlegenheit gegenüber feinabgestimmten Modellen ohne zusätzliches Training;
- die Wiederherstellung von 66,8 % der nach dem Alignment verloren gegangenen Kreativität.
Post-Training-Alignment-Methoden wie RLHF (Reinforcement Learning from Human Feedback) zielen darauf ab, LLMs nützlicher und sicherer zu machen. Allerdings führen diese Methoden unbeabsichtigt zu einer signifikanten Reduktion der Vielfalt generierter Antworten – ein Phänomen, das als „Mode Collapse“ (Modus-Kollaps) bekannt ist.
Wenn LLMs einen Mode Collapse erfahren, beginnt das Modell, eine schmale Auswahl vorhersehbarer oder template-artiger Antworten anderen möglichen Optionen vorzuziehen. Dies geschieht aufgrund eines versteckten Mangels in den menschlichen Präferenzdaten, der sogenannten „Typicality Bias“ (Typizitätsverzerrung).
Der Mechanismus funktioniert wie folgt: Annotatoren bewerten verschiedene LLM-Antworten, woraufhin das Modell unter Verwendung eines Belohnungsmodells trainiert wird, das diese menschlichen Präferenzen reproduzieren soll. Da Annotatoren jedoch natürlicherweise vertrautere, leichter lesbare und vorhersehbare Antworten bevorzugen, neigt das Belohnungsmodell dazu, genau jene Antworten zu verstärken, die das Originalmodell (vor dem Alignment) bereits als am wahrscheinlichsten eingestuft hatte.
Dies führt zu einer übermäßigen Schärfung der Wahrscheinlichkeitsverteilung des LLMs, wodurch das kreative Spektrum der Modellantworten auf ein oder zwei dominante, höchst vorhersehbare Optionen schrumpft.
Dennoch ist dieser Effekt nicht irreversibel. Nach dem Alignment lassen sich LLMs weiterhin konditional in zwei „Persönlichkeiten“ unterscheiden:
- Das ursprüngliche Modell, das während des Pre-Trainings eine reiche Menge möglicher Optionen erlernt hat.
- Das post-alignment Modell, das auf Sicherheit fokussiert ist.
Genau hier setzt Verbalized Sampling (VS) an. Es handelt sich um eine Prompting-Strategie, die kein zusätzliches Training erfordert und darauf ausgelegt ist, den Mode Collapse zu umgehen und die vielfältige Verteilung wiederherzustellen, die während des Pre-Trainings gebildet wurde.
Die Kernidee von Verbalized Sampling besteht darin, dass der Prompt selbst als eine Art mentaler Schalter fungiert. Direkte Anfragen wie „Erzähle einen Witz“ aktivieren sofort die post-alignment Version des Modells, welche die im Training am stärksten verstärkte Antwort liefert.
Bei der Anwendung von Verbalized Sampling sieht der Prompt jedoch so aus: „Generiere 5 Antworten mit entsprechenden Wahrscheinlichkeiten. Erzähle einen Witz.“
In diesem Fall fordert der Prompt nicht eine spezifische Antwort, sondern eine Verteilung. Dadurch beginnt das post-alignment Modell, den gesamten Raum seines Wissens zu beschreiben, und ist gezwungen, die vielfältige Verteilung zu nutzen, die während des Pre-Trainings entstanden ist. So greift das Modell auf eine breitere und diversifiziertere Ideenmenge zurück, die noch immer in seinen Basisgewichten erhalten ist.
Verbalized Sampling erhöht die Diversität der Generierung im Vergleich zum direkten Prompting um das 1,6- bis 2,1-fache, während die Qualität der Antworten beibehalten oder sogar verbessert wird. Varianten wie VS-basiertes Chain-of-Thought (CoT) und VS-basierte Multi-Prompting steigern die Diversität weiter.
Warum das wichtig ist
AnalyseDiese Technik bietet einen kosteneffizienten Weg, die inhärente Kreativität von KI-Modellen zu entfesseln, ohne teure Re-Trainingsprozesse. Sie ist entscheidend für Anwendungen, bei denen Varianz und Originalität wichtiger sind als strikte Konformität.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern