Le MIT apprend aux agents IA à partager le cache KV au lieu du texte
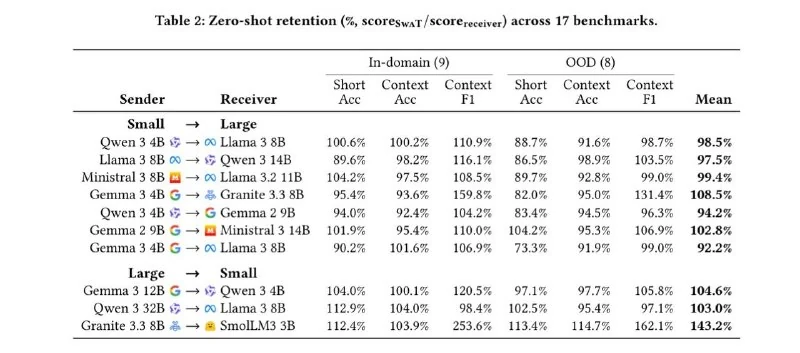
Des chercheurs du MIT ont présenté SwaT, une architecture qui transfère le contexte traité entre modèles et réduit les pertes d'information tout en accélérant les workflows d'agents.
Dans les systèmes multi-agents, le contexte doit être transmis en permanence entre les modèles. Par exemple, lorsqu'un agent termine sa partie d'une tâche et qu'un autre doit poursuivre le travail. On utilise généralement des résumés textuels, mais leur création et leur traitement ultérieur nécessitent des calculs supplémentaires et une partie de l'information est perdue.
Des chercheurs ont proposé SwaT (Swarm Telepathy), une architecture qui permet de transmettre le cache KV, c'est-à-dire le contexte déjà traité, entre modèles, au lieu de résumés textuels. Le procédé fonctionne même entre différentes familles de modèles.
Sur les benchmarks, SwaT combiné à la compression du cache a montré une qualité de réponse moyenne supérieure de 40 % et une accélération quadruplée par rapport à la transmission de résumés textuels. Plus intéressant encore, cette méthode a permis de transférer des informations visuelles d'un modèle de vision et de langage (VLM) vers un modèle texte classique.
Pourquoi c'est important
AnalyseCela réduit les calculs redondants et la perte de contexte dans les workflows d'agents et permet une coordination plus efficace entre modèles hétérogènes, y compris le transfert d'informations visuelles.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs
Lié dans l'écosystème
Guides pratiques, terminologie clé et compétences d'agents
Claude Code Projects : comment une IA coordonne une équipe d'agents autonomes
Analyse approfondie de Claude Code Projects : architecture Coordinator et Threads, branches parallèles, mémoire partagée MEMORY.md et gestion des agents cloud.
Agents IA (Agents autonomes)
Systèmes logiciels basés sur des LLM, capables de percevoir de manière autonome l'état de leur environnement, de décomposer des objectifs complexes, d'appeler des outils externes et de corriger itérativement leurs propres erreurs.
Déchargement et compression du KV-Cache
Méthodes matérielles et algorithmiques permettant de décharger temporairement le cache des clés et des valeurs (KV-Cache) de la mémoire vidéo GPU coûteuse vers la mémoire vive système (RAM) ou des SSD NVMe rapides.
Jev et System One AI : guide pratique complet du modèle de décision TypeSafe
Analyse technique approfondie du modèle phare Jev : architecture System One vs LLM, primitives Choice/Score/Noul, parallélisme des requêtes, mathématiques de la confiance, études de cas vidéo, code et aperçu des alternatives open-weight locales (Laya, GLiNER2.5, CLM-8B).