MIT ensina agentes de IA a compartilhar cache KV em vez de texto
Pesquisadores do MIT apresentaram o SwaT, uma arquitetura que transfere contexto processado entre modelos, reduzindo perdas e acelerando fluxos de trabalho de agentes.
Em sistemas multiagente, o contexto precisa ser transferido constantemente entre modelos. Por exemplo, quando um agente conclui sua parte de uma tarefa e outro precisa continuar o trabalho. Normalmente, usam-se resumos textuais, mas criá-los e reprocessá-los exige computação extra, e parte da informação se perde.
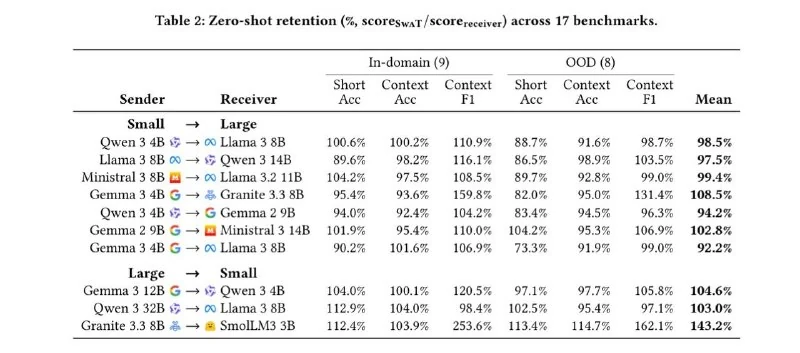
Pesquisadores propuseram SwaT (Swarm Telepathy), uma arquitetura que permite transferir o cache KV, ou seja, o contexto já processado, entre modelos em vez de resumos textuais. O método funciona até entre diferentes famílias de modelos.
Em benchmarks, o SwaT combinado com compressão de cache apresentou 40% mais qualidade média nas respostas e aceleração de quatro vezes em comparação com a transmissão de resumos textuais. Ainda mais interessante, esse método permitiu transferir informações visuais de um modelo de visão e linguagem (VLM) para um modelo de texto convencional.
Por que isso importa
AnáliseReduz computação redundante e perda de contexto em fluxos de agentes e permite uma coordenação mais eficiente entre modelos heterogêneos, incluindo a transferência de informações visuais.
Debater na comunidade
Compartilhe suas dúvidas e insights com desenvolvedores
Relacionado no ecossistema
Guias práticos, terminologia essencial e skills de agentes
Projetos do Claude Code: como um único IA coordena uma equipe de agentes autônomos
Análise aprofundada dos Projetos do Claude Code: arquitetura Coordinator e Threads, branches paralelas, memória compartilhada MEMORY.md e gerenciamento de agentes na nuvem.
Agentes de IA (Agentes Autônomos)
Sistemas de software baseados em LLMs, capazes de perceber autonomamente o estado do ambiente, decompor objetivos complexos, invocar ferramentas externas e corrigir iterativamente os seus próprios erros.
Descarregamento e Compressão do KV-Cache
Métodos de hardware e algoritmos para o descarregamento temporário do cache de chaves e valores (KV-Cache) da memória de vídeo GPU, de alto custo, para a memória RAM do sistema ou SSDs NVMe rápidos.
Jev e System One AI: guia prático completo sobre o modelo de decisão da TypeSafe
Análise técnica aprofundada do modelo principal Jev: arquitetura System One versus LLM, primitivos Choice/Score/Noul, paralelismo de requisições, matemática da confiança, casos de vídeo, código e visão geral de alternativas open-weight locais (Laya, GLiNER2.5, CLM-8B).