У MIT ШІ-агентів навчили обмінюватися KV-кешем замість тексту
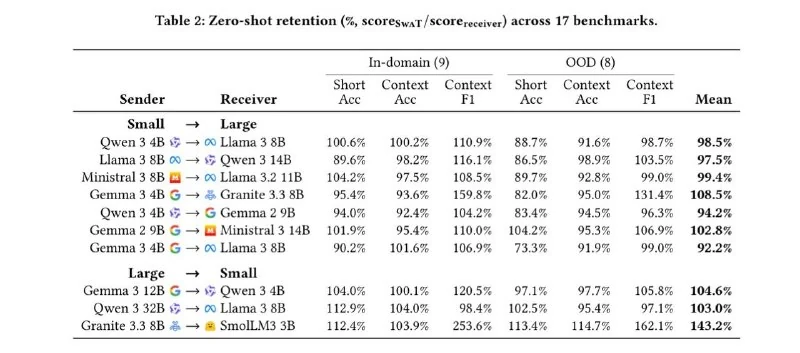
Дослідники представили архітектуру SwaT, яка передає оброблений контекст між моделями в мультиагентних системах, скорочуючи втрати та прискорюючи роботу.
У мультиагентних системах контекст постійно передається між моделями. Наприклад, коли один агент завершує свою частину задачі, а інший має продовжити роботу. Зазвичай для цього використовують текстові перекази, але на їхнє створення й повторну обробку витрачаються зайві обчислення, а частина інформації втрачається.
Дослідники запропонували SwaT (Swarm Telepathy) — архітектуру, яка дозволяє передавати між моделями KV-кеш, тобто вже оброблений контекст, замість текстових переказів. Вона працює навіть між різними сімействами моделей.
На бенчмарках SwaT у поєднанні зі стисненням кешу показав в середньому на 40% вищу якість відповідей і чотирикратне прискорення порівняно з передачею текстових переказів. Ще цікавіше, що таким способом вдалося передати візуальну інформацію від візуально-мовної моделі (VLM) звичайній текстовій моделі.
Чому це важливо
АналітикаЦе зменшує дублювання обчислень і втрати контексту в агентних робочих процесах, відкриваючи шлях до ефективнішої координації між різними моделями, включно з передачею візуальної інформації.
Обговорити новину у спільноті
Діліться своїм досвідом та думками з ШІ-розробниками
Пов'язані матеріали екосистеми
Практичні гайди, термінологія та агентські скіли
Claude Code Projects: як один ШІ координує команду автономних агентів
Глибокий аналіз Claude Code Projects: архітектура Coordinator та Threads, паралельні гілки, спільна пам'ять MEMORY.md та управління хмарними агентами.
Jev та System One AI: повний практичний гайд по моделі рішень від TypeSafe
Глибокий інженерний розбір флагманської моделі Jev: архітектура System One проти LLM, примітиви Choice/Score/Noul, паралелізм запитів, математика впевненості, відео-кейси, код та огляд локальних open-weight альтернатив (Laya, GLiNER2.5, CLM-8B).
AI-агенти (Autonomous Agents)
Програмні системи на базі LLM, здатні самостійно сприймати стан середовища, декомпозувати складні цілі, викликати зовнішні інструменти та ітеративно виправляти власні помилки.
KV-Cache Offloading & Compression
Апаратні та алгоритмічні методи тимчасового вивантаження кешу ключів і значень (KV-Cache) із дорогої відеопам'яті GPU у системну оперативну пам'ять (RAM) або швидкі NVMe SSD.