MIT enseña a agentes de IA a compartir caché KV en lugar de texto
Investigadores de MIT presentaron SwaT, una arquitectura que transfiere contexto procesado entre modelos en sistemas multiagente, reduciendo pérdidas y acelerando los flujos de trabajo.
En los sistemas multiagente, el contexto debe transferirse constantemente entre modelos. Por ejemplo, cuando un agente termina su parte de una tarea y otro debe continuar el trabajo. Normalmente se usan resúmenes de texto, pero crearlos y volver a procesarlos requiere cómputo adicional y parte de la información se pierde.
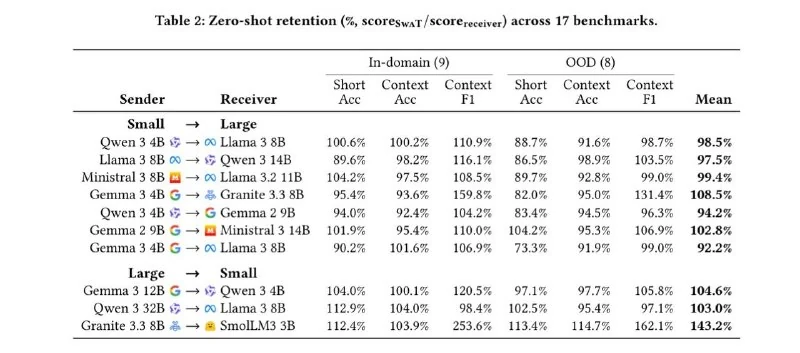
Investigadores propusieron SwaT (Swarm Telepathy), una arquitectura que permite transferir el caché KV, es decir, el contexto ya procesado, entre modelos en lugar de resúmenes textuales. Funciona incluso entre diferentes familias de modelos.
En benchmarks, SwaT combinado con compresión del caché mostró una calidad media de respuesta 40% superior y una aceleración de cuatro veces frente a la transmisión de resúmenes textuales. Aún más interesante, este método permitió transferir información visual desde un modelo de visión y lenguaje (VLM) a un modelo de texto convencional.
Por qué es importante
AnálisisReduce cómputo redundante y pérdida de contexto en flujos de agentes y permite una coordinación más eficiente entre modelos heterogéneos, incluida la transferencia de información visual a modelos de texto.
Debatir en la comunidad
Comparte tus preguntas e ideas con desarrolladores
Relacionado en el ecosistema
Guías prácticas, terminología y skills de agentes
Proyectos de Claude Code: cómo una IA coordina un equipo de agentes autónomos
Análisis exhaustivo de Proyectos de Claude Code: arquitectura Coordinator y Threads, ramas paralelas, memoria compartida MEMORY.md y gestión de agentes en la nube.
Agentes de IA (Agentes Autónomos)
Sistemas de software basados en LLM que pueden percibir de manera autónoma el estado del entorno, descomponer objetivos complejos, invocar herramientas externas y corregir iterativamente sus propios errores.
Jev y System One AI: guía práctica completa del modelo de decisiones de TypeSafe
Análisis ingenieril profundo del modelo insignia Jev: arquitectura System One frente a LLM, primitivas Choice/Score/Noul, paralelismo de consultas, matemática de la confianza, casos de vídeo, código y revisión de alternativas open-weight locales (Laya, GLiNER2.5, CLM-8B).
KV-Cache Offloading y Compresión
Métodos hardware y algorítmicos para la descarga temporal de la caché de claves y valores (KV-Cache) desde la costosa memoria de video GPU a la memoria RAM del sistema o a rápidos SSD NVMe.