Meta dévoile une nouvelle loi d'échelle révolutionnaire
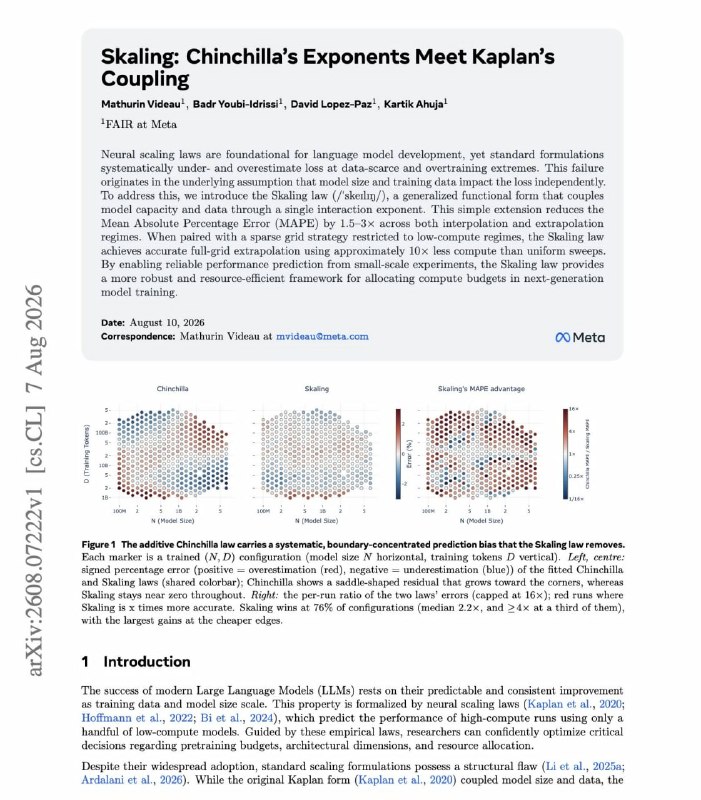
Meta introduit la « Skaling law », une innovation qui lie la capacité du modèle et le volume de données via un paramètre d'interaction unique, promettant des gains majeurs en précision et en efficacité.
Une avancée significative signée par Meta.
Habituellement, les lois d'échelle supposent que la taille du modèle et le volume de données influencent l'erreur de manière indépendante l'une de l'autre.
Dans cette étude, les auteurs présentent la Skaling law — une loi qui relie la capacité du modèle et les données à travers un seul paramètre d'interaction.
L'introduction d'un terme supplémentaire réduit l'erreur absolue moyenne en pourcentage d'environ 1,5 à 3 fois, tant lors de l'interpolation que de l'extrapolation.
Les améliorations les plus notables se manifestent dans les régimes où les données sont rares ou lorsque le modèle est fortement surajusté. C'est précisément dans ces zones que les lois standard de Chinchilla et Kaplan commencent à montrer des écarts significatifs.
Un autre aspect crucial : couplée à une grille clairsemée de petites expériences, cette méthode permet d'extrapoler l'image complète avec des coûts de calcul environ 10 fois inférieurs à ceux d'une énumération uniforme.
Pourquoi cela compte ?
Aujourd'hui, les modèles sont souvent entraînés et déployés bien au-delà du régime classique optimal en termes de calcul. Si la loi d'échelle reste précise dans ce domaine, et qu'elle peut être estimée sur de petites expériences, elle modifie directement la façon dont les budgets de pré-entraînement peuvent être planifiés.
Pourquoi c'est important
AnalyseCette nouvelle loi d'échelle pourrait transformer les approches d'entraînement des modèles en réduisant drastiquement les coûts computationnels tout en améliorant la précision. Elle ouvre de nouvelles perspectives pour l'optimisation stratégique des budgets de pré-entraînement.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs