Nova Lei de Escala da Meta redefine o treinamento de modelos
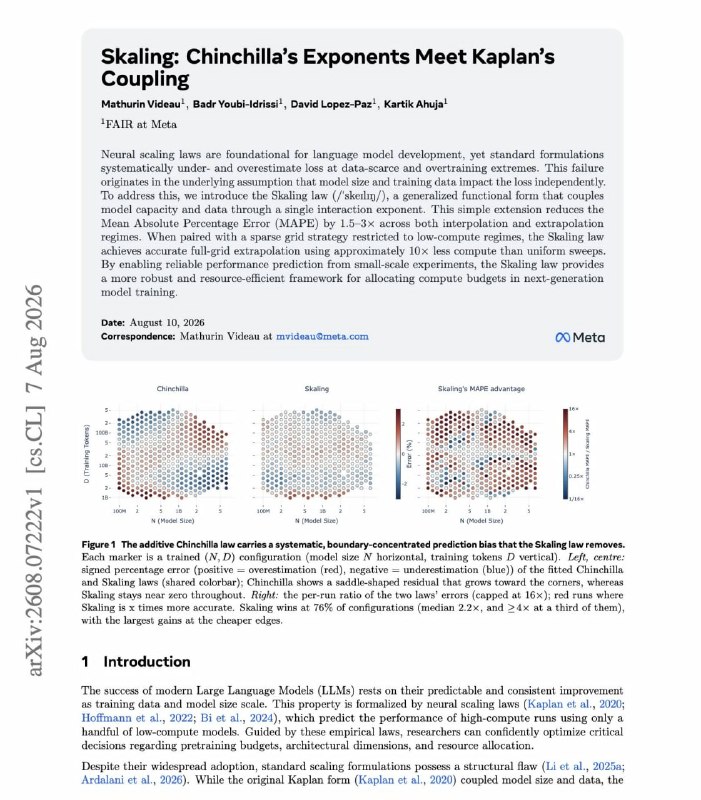
A Meta introduziu uma nova lei de escala que conecta a capacidade do modelo e os dados por meio de um único parâmetro de interação, prometendo transformar drasticamente as estratégias de orçamento para pré-treinamento.
Um trabalho robusto apresentado pela Meta.
Normalmente, as leis de escala assumem que o tamanho do modelo e o volume de dados afetam o erro de forma independente entre si.
Neste estudo, os autores apresentam a Skaling Law — uma lei que conecta a capacidade do modelo e os dados através de um único parâmetro de interação.
Um termo adicional reduz o erro percentual absoluto médio em aproximadamente 1,5 a 3 vezes, tanto para interpolação quanto para extrapolação.
As melhorias mais notáveis ocorrem em regimes onde os dados são escassos ou o modelo está fortemente sobreajustado. É precisamente nessas áreas que as leis padrão de Chinchilla e Kaplan começam a falhar significativamente.
Outro aspecto importante: junto com uma grade esparsa de execuções pequenas, o método permite extrapolar o panorama completo com custos computacionais cerca de 10 vezes menores do que a enumeração uniforme.
Por que isso importa?
Hoje, os modelos são frequentemente treinados e implantados muito além do regime classicamente ótimo em termos computacionais. Se a lei de escala permanecer precisa nessa faixa, e puder ser estimada em execuções pequenas, ela altera diretamente como os orçamentos para pré-treinamento podem ser planejados.
Por que isso importa
AnáliseEsta nova lei de escala pode alterar significativamente as abordagens de treinamento de modelos, reduzindo custos computacionais e aumentando a precisão. Ela abre novas possibilidades para a otimização dos orçamentos de pré-treinamento.
Debater na comunidade
Compartilhe suas dúvidas e insights com desenvolvedores