Meta stellt neues Skalierungsgesetz vor
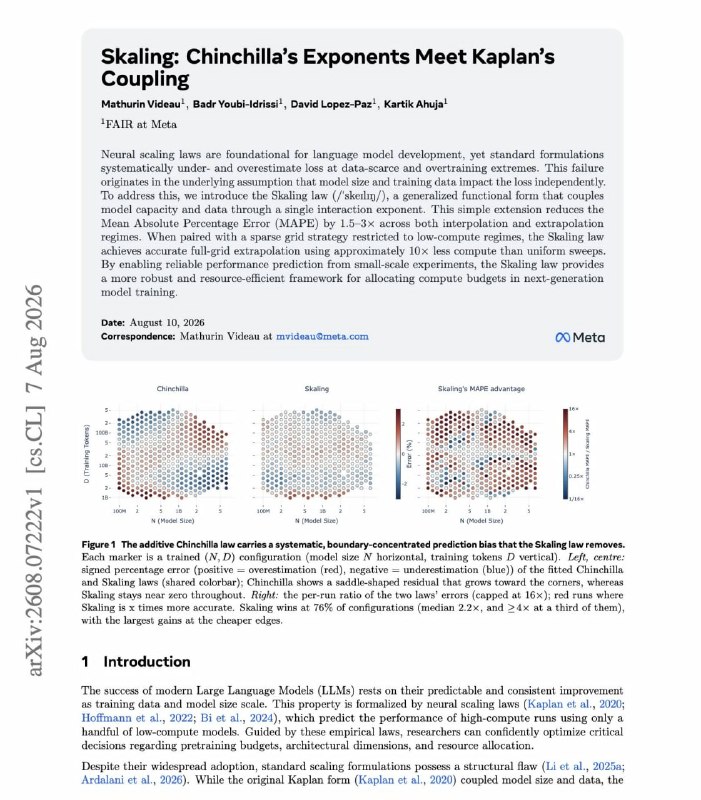
Meta hat ein neues Skalierungsgesetz eingeführt, das Modellkapazität und Datenmenge über einen einzigen Interaktionsparameter verknüpft. Dies könnte die Budgetplanung für das Pre-Training von Modellen grundlegend verändern.
Ein überzeugendes neues Werk von Meta.
Typischerweise gehen Skalierungsgesetze davon aus, dass Modellgröße und Datenvolumen den Fehler unabhängig voneinander beeinflussen.
In dieser Arbeit führen die Autoren das Skaling-Gesetz ein – eine Gesetzmäßigkeit, die Modellkapazität und Daten durch einen einzigen Interaktionsparameter miteinander verbindet.
Ein zusätzlicher Term reduziert den durchschnittlichen absoluten prozentualen Fehler bei Interpolation und Extrapolation um das 1,5- bis 3-fache.
Die bemerkenswertesten Verbesserungen treten in Bereichen auf, in denen Daten knapp sind oder das Modell stark überangepasst (overfitted) ist. Genau hier beginnen die Standardgesetze nach Chinchilla und Kaplan signifikante Abweichungen zu zeigen.
Ein weiterer wichtiger Aspekt: Zusammen mit einem dünn besetzten Gitter kleiner Läufe ermöglicht die Methode die Extrapolation des gesamten Bildes mit etwa zehnmal geringeren Rechenkosten als bei einer gleichmäßigen Enumeration.
Warum ist das relevant?
Heutzutage werden Modelle oft weit jenseits der klassischen rechnerisch optimalen Regime trainiert und eingesetzt. Wenn das Skalierungsgesetz dort weiterhin genau bleibt und sich anhand kleiner Läufe abschätzen lässt, verändert dies direkt die Planung der Budgets für das Pre-Training.
Warum das wichtig ist
AnalyseDieses neue Skalierungsgesetz kann die Ansätze zum Training von Modellen erheblich verändern, indem es die Rechenkosten senkt und die Genauigkeit verbessert. Es eröffnet neue Möglichkeiten zur Optimierung der Budgets für das Pre-Training.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern