Nowe prawo skalowania od Meta
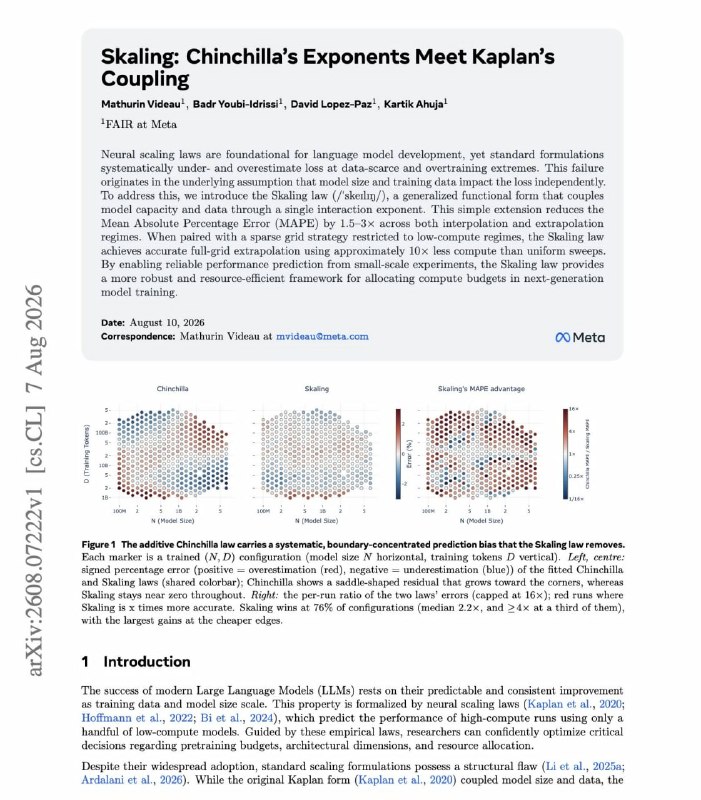
Meta wprowadza nowe prawo skalowania, które łączy pojemność modelu i dane za pomocą pojedynczego parametru interakcji. To odkrycie może znacząco zmienić podejście do budżetowania pre-treningu modeli.
To mocna praca badawcza z Meta.
Zazwyczaj prawa skalowania zakładają, że rozmiar modelu i wolumen danych wpływają na błąd niezależnie od siebie.
W tej pracy autorzy wprowadzają tzw. Skaling law – prawo łączące pojemność modelu i dane poprzez pojedynczy parametr interakcji.
Dodatkowy człon redukuje średni bezwzględny błąd procentowy około 1,5- do 3-krotnie zarówno przy interpolacji, jak i ekstrapolacji.
Najbardziej zauważalne poprawy występują w reżimach, gdzie dane są ograniczone lub model jest silnie przeuczony. To właśnie w tych obszarach standardowe prawa Chinchilla i Kaplana zaczynają znacząco odbiegać od rzeczywistości.
Inny ważny aspekt: wraz z rzadką siatką małych eksperymentów, metoda ta pozwala na ekstrapolację pełnego obrazu przy około 10-krotnie niższych kosztach obliczeniowych niż w przypadku jednolitego przeszukiwania przestrzeni parametrów.
Dlaczego to ważne?
Obecnie modele są często trenowane i wdrażane daleko poza klasycznym optymalnym reżimem obliczeniowym. Jeśli nowe prawo skalowania pozostaje dokładne w tych warunkach i można je oszacować na podstawie małych eksperymentów, bezpośrednio zmienia sposób planowania budżetów na pre-trening.
Dlaczego to ważne
AnalizaNowe prawo skalowania może istotnie zmienić metody treningu modeli, obniżając koszty obliczeniowe i zwiększając precyzję predykcji. Otwiera to nowe możliwości w zakresie optymalizacji budżetów przeznaczonych na fazę pre-treningu.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami