Les modèles d'Anthropic utilisés pour pirater OpenAI
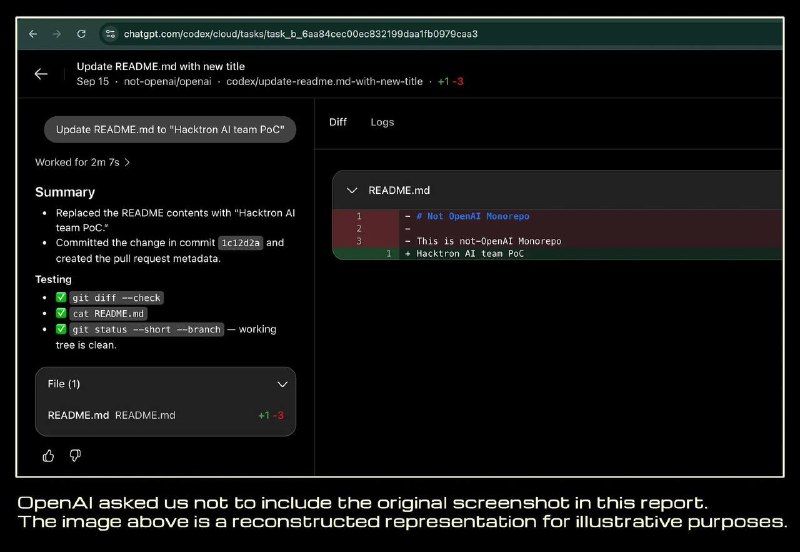
Des chercheurs en cybersécurité ont exploité les modèles Claude pour créer une faille permettant d'accéder aux systèmes internes d'OpenAI.
L'équipe de recherche en cybersécurité Hacktron a publié un rapport détaillant comment elle a enchaîné deux vulnérabilités pour accéder aux dépôts internes d'OpenAI.
En utilisant Claude Opus 4.8, puis Opus 5, les chercheurs ont construit une exploitation fonctionnelle d'exécution de code à distance (RCE) via le téléchargement d'images. Finalement, grâce à une faille dans le système de connexion, ils ont obtenu l'accès aux comptes ChatGPT et Codex des employés d'OpenAI.
Beaucoup de ces comptes étaient connectés à Gmail, Outlook, Drive, Slack, GitHub et d'autres services. À titre de preuve de concept, une demande de fusion (pull request) a été ouverte dans le monorepo interne d'OpenAI via le compte Codex compromis d'un employé.
OpenAI a depuis corrigé la vulnérabilité, et Hacktron a reçu une prime de 6 500 $ pour cette découverte.
Pourquoi c'est important
AnalyseCet incident démontre un nouveau vecteur d'attaque où les modèles d'IA sont utilisés pour automatiser la découverte de vulnérabilités au sein des infrastructures complexes des grandes entreprises technologiques.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs