Modelos da Anthropic auxiliaram na invasão de sistemas internos da OpenAI
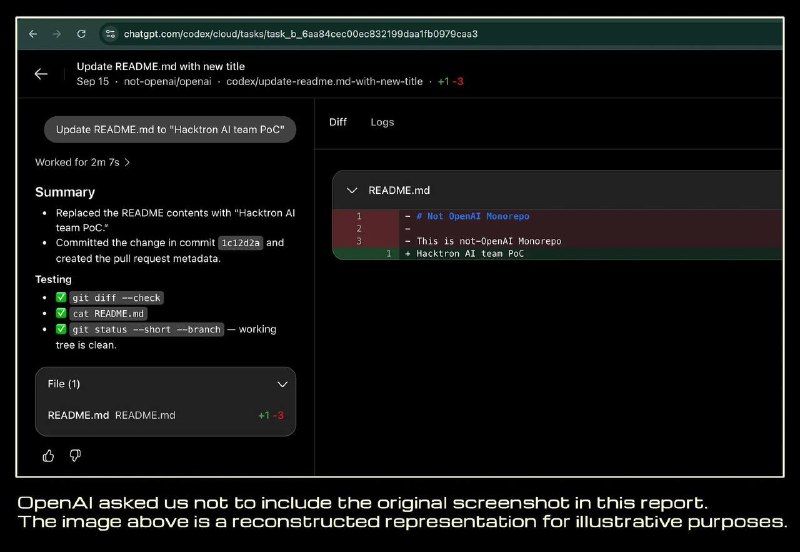
Pesquisadores de cibersegurança utilizaram modelos Claude para explorar vulnerabilidades e acessar repositórios internos da OpenAI.
A equipe de pesquisa em cibersegurança Hacktron publicou um relatório detalhando como encadeou duas vulnerabilidades para obter acesso aos repositórios internos da OpenAI.
Utilizando o Claude Opus 4.8, seguido pelo Opus 5, os pesquisadores construíram uma exploração funcional de execução remota de código (RCE) por meio do upload de imagens. Por fim, devido a uma falha no sistema de login, conseguiram acessar as contas de ChatGPT e Codex dos funcionários da OpenAI.
Muitas dessas contas estavam conectadas ao Gmail, Outlook, Drive, Slack, GitHub e outros serviços. Como prova de conceito, foi aberto um pull request no monorepo interno da OpenAI através da conta Codex comprometida de um funcionário.
A OpenAI já corrigiu a vulnerabilidade, e a Hacktron recebeu uma recompensa de US$ 6.500 pela descoberta.
Por que isso importa
AnáliseEste caso demonstra uma nova vetor de ataque onde modelos de IA são utilizados para automatizar a descoberta de vulnerabilidades em infraestruturas complexas de grandes empresas de tecnologia.
Debater na comunidade
Compartilhe suas dúvidas e insights com desenvolvedores
Relacionado no ecossistema
Guias práticos, terminologia essencial e skills de agentes
AI Radar: GPT-6.1 Terra, Gemini 4 Carbon, Mistral Large 4 e mudanças de preços da OpenAI e da Anthropic
Resumo das novidades de IA: novos modelos LLM, mudanças nas assinaturas da OpenAI e da Anthropic, world models, geradores de vídeo e detalhes corporativos.
Claude Haiku (Modelos compactos e rápidos da Anthropic)
O modelo mais compacto e rápido da linha Anthropic. Projetado para respostas instantâneas, classificação de texto em massa, extração de dados e roteamento de agentes com custo mínimo.
OpenAI GPT (Modelos Flagship da Série GPT)
A principal linha universal de grandes modelos de linguagem da OpenAI (GPT-4, GPT-4o). Otimizada para análise textual complexa, programação, criatividade e trabalho intelectual diário.
Serviço avalia risco de banimento pela Anthropic
Desenvolvedores chineses criaram um serviço que analisa o endereço IP, país, provedor, tipo de conexão e vazamentos de DNS e WebRTC, atribuindo uma pontuação de confiança de 0 a 100 para acessos ligados à Anthropic.