Modele Anthropica pomogły w hakerskim ataku na OpenAI
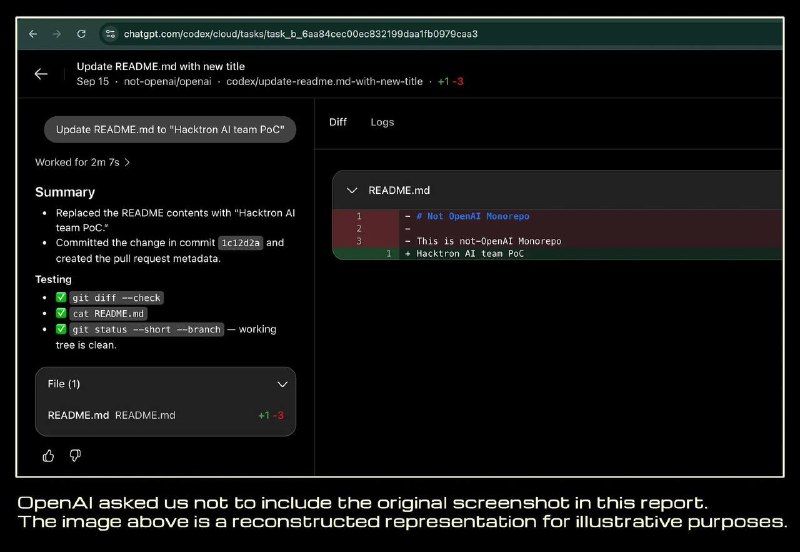
Badacze z Hacktron wykorzystali modele Claude do stworzenia exploita, który umożliwił dostęp do wewnętrznych systemów OpenAI.
Zespół badawczy ds. cyberbezpieczeństwa Hacktron opublikował raport szczegółowo opisujący, jak połączono dwie podatności, aby uzyskać dostęp do wewnętrznych repozytoriów OpenAI.
Korzystając z modelu Claude Opus 4.8, a następnie Opus 5, badacze skonstruowali działający exploit umożliwiający zdalne wykonanie kodu (RCE) poprzez przesyłanie obrazów. Ostatecznie, dzięki luce w systemie logowania, uzyskali dostęp do kont pracowników OpenAI w serwisach ChatGPT i Codex.
Wiele z tych kont było powiązanych z usługami Gmail, Outlook, Drive, Slack, GitHub i innymi. Jako dowód koncepcji (proof of concept), za pośrednictwem przejętego konta Codex pracownika otwarto pull request w wewnętrznym monorepo OpenAI.
OpenAI od czasu wykrycia problemu załatało tę podatność, a zespół Hacktron otrzymał nagrodę w wysokości 6 500 dolarów za zgłoszenie luki.
Dlaczego to ważne
AnalizaPrzypadek ten ilustruje nowy wektor ataku, w którym modele AI są wykorzystywane do automatyzacji odkrywania podatności w złożonej infrastrukturze dużych firm technologicznych.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami