Premiera Qwen3.8-Omni-Flash: Multimodalny model z kontekstem 1 mln tokenów
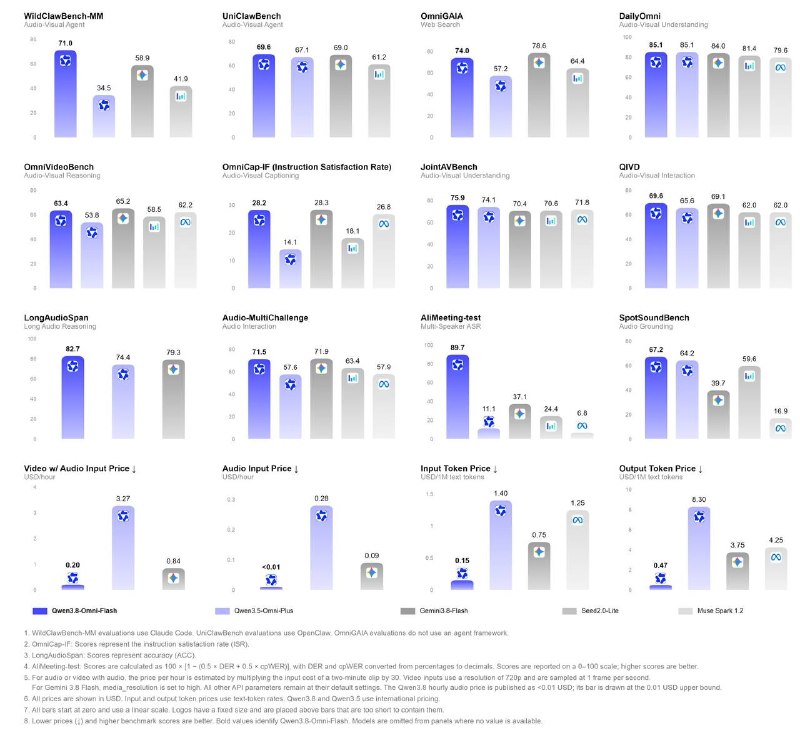
Qwen wprowadził na rynek Qwen3.8-Omni-Flash, multimodalny model obsługujący okno kontekstowe do 1 miliona tokenów, ze znacząco ulepszonym rozumieniem wideo i drastycznie obniżonymi kosztami przetwarzania audio oraz wideo.
Premiera Qwen3.8-Omni-Flash
Programiści określają go jako pierwszy w tej linii model multimodalny zbudowany wokół zdolności agentowych (agentic capabilities). Model przyjmuje jako dane wejściowe tekst, obrazy, dźwięk oraz wideo, dysponując oknem kontekstowym wynoszącym 1 milion tokenów.
Znacznie ulepszono funkcje rozumienia i przetwarzania wideo: model lepiej radzi sobie z długimi nagraniami, potrafi generować na ich podstawie dogłębne raporty badawcze lub opisy, a także nie „halucynuje” znaczników czasu (timecodes). Jednocześnie możliwości w zakresie przetwarzania tekstu pozostają na poziomie standardowego modelu Qwen-3.8 Flash.
Ogólnie rzecz biorąc, ten model został zaprojektowany jako ogniwo pośrednie dla przyszłego pełnego pipeline’u scenariuszy takich jak edycja wideo, tłumaczenie, komentarze filmowe czy tworzenie treści.
W porównaniu z poprzednią wersją Qwen3.5-Omni-Flash zużycie tokenów również znacząco spadło, co przełożyło się na niższe ceny:
- Przetwarzanie audio jest tańsze o 98%;
- Przetwarzanie audio-wideo jest tańsze o ponad 93%.
Takie wyniki osiągnięto przy wydajności porównywalnej z Gemini 3.8 Flash.
Model jest już dostępny w API oraz w Qwen Chat.
Dlaczego to ważne
AnalizaTa premiera ma kluczowe znaczenie dla deweloperów AI pracujących na danych multimodalnych, oferując wysoką wydajność i zdolności agentowe przy ułamku wcześniejszych kosztów, co jest szczególnie istotne dla aplikacji intensywnie wykorzystujących wideo.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami