Qwen3.8-Omni-Flash veröffentlicht: Multimodales Modell mit 1-Million-Token-Kontext
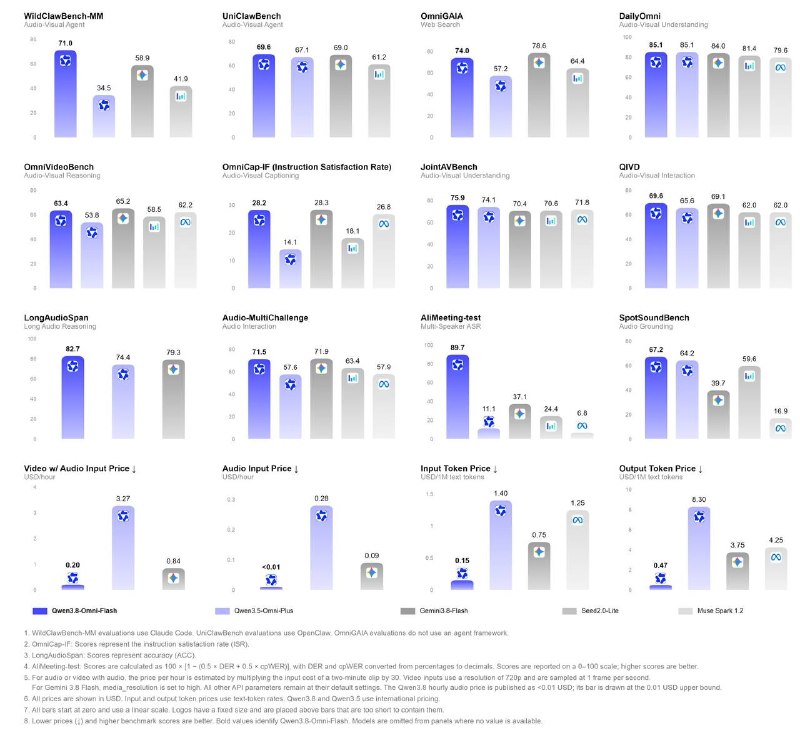
Qwen hat Qwen3.8-Omni-Flash vorgestellt, ein multimodales Modell mit einem Kontextfenster von einer Million Token, verbesserter Videoanalyse und drastisch gesenkten Kosten für Audio- und Videoverarbeitung.
Veröffentlichung von Qwen3.8-Omni-Flash
Entwickler bezeichnen es als das erste multimodale Modell in der Produktlinie, das speziell um agentische Fähigkeiten herum konzipiert wurde. Es versteht Text, Bilder, Audio und Video als Eingabe und verfügt über ein Kontextfenster von 1 Million Token.
Die Videoanalyse und -verarbeitung wurden erheblich verbessert: Das Modell versteht lange Videos deutlich besser, kann darauf basierend tiefgehende Rechercheberichte oder Untertitel generieren und halluziniert keine Zeitcodes mehr. Gleichzeitig bleiben die Textfähigkeiten auf dem Niveau des Standardmodells Qwen-3.8 Flash erhalten.
Insgesamt ist dieses Modell als Zwischenglied für eine zukünftige vollständige Pipeline für Szenarien wie Videobearbeitung, Übersetzung, Filmkommentare und Content-Erstellung konzipiert.
Im Vergleich zum vorherigen Qwen3.5-Omni-Flash wurde auch der Tokenverbrauch signifikant gesenkt, was zu niedrigeren Preisen führt:
- Die Audioverarbeitung ist 98 % günstiger;
- Die Audio-Video-Verarbeitung ist mehr als 93 % günstiger.
Dies wird bei einer Leistung erreicht, die mit Gemini 3.8 Flash vergleichbar ist.
Das Modell ist bereits über die API und in Qwen Chat verfügbar.
Warum das wichtig ist
AnalyseDiese Veröffentlichung ist entscheidend für KI-Entwickler, die mit multimodalen Daten arbeiten, da sie hohe Leistung und agentische Fähigkeiten zu einem Bruchteil der bisherigen Kosten bietet, insbesondere für videointensive Anwendungen.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern