Anthropic-Modelle ermöglichten Hack von OpenAI
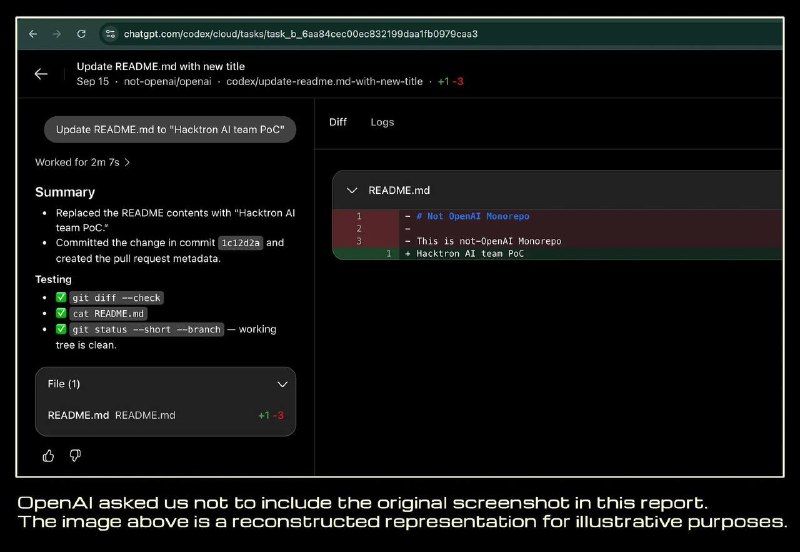
Cybersecurity-Forscher nutzten Claude-KI-Modelle, um eine Exploit-Kette zu entwickeln und Zugriff auf interne Systeme von OpenAI zu erlangen.
Das Cybersecurity-Research-Team Hacktron hat einen Bericht veröffentlicht, der detailliert beschreibt, wie zwei Schwachstellen kombiniert wurden, um Zugang zu den internen Repositories von OpenAI zu erhalten.
Unter Verwendung von Claude Opus 4.8, gefolgt von Opus 5, konstruierten die Forscher einen funktionierenden Remote Code Execution (RCE)-Exploit über den Bildupload-Prozess. Letztlich gelang es ihnen aufgrund eines Fehlers im Login-System, Zugriff auf die ChatGPT- und Codex-Konten von OpenAI-Mitarbeitern zu erlangen.
Viele dieser Konten waren mit Gmail, Outlook, Drive, Slack, GitHub und weiteren Diensten verknüpft. Als Proof-of-Concept wurde über das kompromittierte Codex-Konto eines Mitarbeiters ein Pull Request in OpenAIs internem Monorepo eröffnet.
OpenAI hat die Schwachstelle inzwischen gepatcht, und Hacktron erhielt für die Entdeckung eine Bug-Bounty in Höhe von 6.500 US-Dollar.
Warum das wichtig ist
AnalyseDieser Vorfall demonstriert eine neue Angriffsvektoren-Strategie, bei der KI-Modelle eingesetzt werden, um die automatisierte Erkennung von Schwachstellen in komplexen Infrastrukturen großer Technologieunternehmen zu beschleunigen.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern