Modelos da Anthropic auxiliaram na invasão de sistemas internos da OpenAI
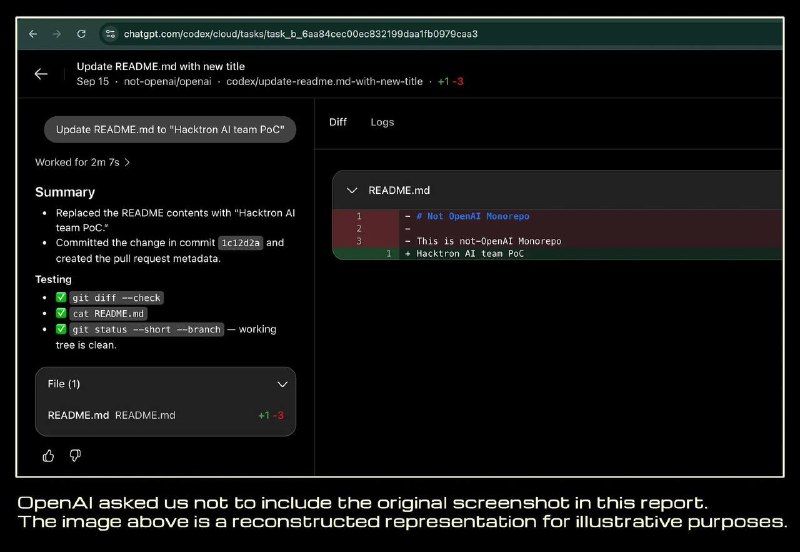
Pesquisadores de cibersegurança utilizaram modelos Claude para explorar vulnerabilidades e acessar repositórios internos da OpenAI.
A equipe de pesquisa em cibersegurança Hacktron publicou um relatório detalhando como encadeou duas vulnerabilidades para obter acesso aos repositórios internos da OpenAI.
Utilizando o Claude Opus 4.8, seguido pelo Opus 5, os pesquisadores construíram uma exploração funcional de execução remota de código (RCE) por meio do upload de imagens. Por fim, devido a uma falha no sistema de login, conseguiram acessar as contas de ChatGPT e Codex dos funcionários da OpenAI.
Muitas dessas contas estavam conectadas ao Gmail, Outlook, Drive, Slack, GitHub e outros serviços. Como prova de conceito, foi aberto um pull request no monorepo interno da OpenAI através da conta Codex comprometida de um funcionário.
A OpenAI já corrigiu a vulnerabilidade, e a Hacktron recebeu uma recompensa de US$ 6.500 pela descoberta.
Por que isso importa
AnáliseEste caso demonstra uma nova vetor de ataque onde modelos de IA são utilizados para automatizar a descoberta de vulnerabilidades em infraestruturas complexas de grandes empresas de tecnologia.
Debater na comunidade
Compartilhe suas dúvidas e insights com desenvolvedores