Los modelos de Anthropic ayudaron a hackear OpenAI
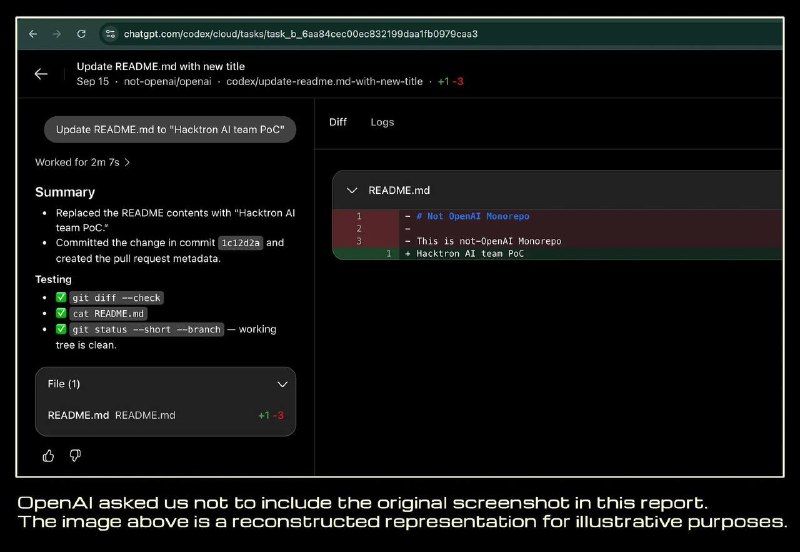
Investigadores de seguridad de Hacktron utilizaron modelos de Claude para crear un exploit que permitió el acceso a los sistemas internos de OpenAI.
El equipo de investigadores de ciberseguridad Hacktron publicó un informe sobre cómo encadenaron dos vulnerabilidades para obtener acceso a los repositorios internos de OpenAI.
Utilizando Claude Opus 4.8 y luego Opus 5, los investigadores construyeron un exploit funcional de ejecución remota de código (RCE) a través de la carga de imágenes, y finalmente, gracias a un error en el sistema de inicio de sesión, obtuvieron acceso a las cuentas de ChatGPT y Codex de los empleados de OpenAI.
Muchas de estas cuentas estaban conectadas a Gmail, Outlook, Drive, Slack, GitHub, etc. Como prueba, se abrió una pull request en el monorepo interno de OpenAI a través de Codex de un empleado comprometido.
OpenAI ya ha cerrado la vulnerabilidad, y Hacktron recibió 6500 dólares por el hallazgo.
Por qué es importante
AnálisisEsto demuestra un nuevo vector de ataque donde los modelos de IA se utilizan para automatizar el descubrimiento de vulnerabilidades en infraestructuras complejas de grandes empresas tecnológicas.
Debatir en la comunidad
Comparte tus preguntas e ideas con desarrolladores
Relacionado en el ecosistema
Guías prácticas, terminología y skills de agentes
AI Radar: GPT-6.1 Terra, Gemini 4 Carbon, Mistral Large 4 y cambios de precios de OpenAI y Anthropic
Resumen de novedades de IA: nuevos modelos LLM, cambios en suscripciones de OpenAI y Anthropic, modelos de mundo, generadores de vídeo y detalles corporativos.
Claude Haiku (Modelos Compactos Rápidos de Anthropic)
El modelo más compacto y rápido de la línea de Anthropic. Diseñado para respuestas instantáneas, clasificación masiva de textos, extracción de datos y enrutamiento agente a un costo mínimo.
OpenAI GPT (Modelos Flagship de la Serie GPT)
La principal línea universal de grandes modelos de lenguaje de OpenAI (GPT-4, GPT-4o). Optimizada para análisis de texto complejo, programación, creatividad y trabajo intelectual diario.
Servicio que evalúa el riesgo de bloqueo por parte de Anthropic
Desarrolladores chinos lanzaron un servicio que analiza la dirección IP, el país, el proveedor, el tipo de conexión y las filtraciones de DNS y WebRTC para puntuar la confianza de 0 a 100 frente a Anthropic.