Modele Anthropica pomogły w hakerskim ataku na OpenAI
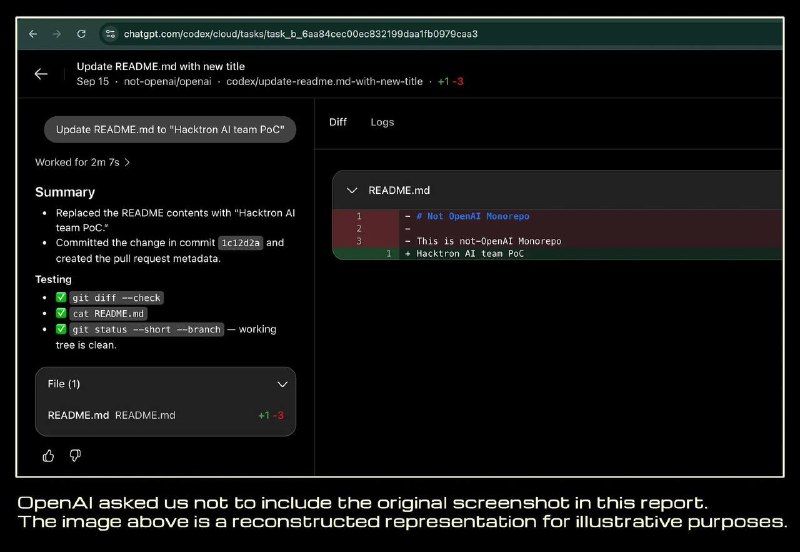
Badacze z Hacktron wykorzystali modele Claude do stworzenia exploita, który umożliwił dostęp do wewnętrznych systemów OpenAI.
Zespół badawczy ds. cyberbezpieczeństwa Hacktron opublikował raport szczegółowo opisujący, jak połączono dwie podatności, aby uzyskać dostęp do wewnętrznych repozytoriów OpenAI.
Korzystając z modelu Claude Opus 4.8, a następnie Opus 5, badacze skonstruowali działający exploit umożliwiający zdalne wykonanie kodu (RCE) poprzez przesyłanie obrazów. Ostatecznie, dzięki luce w systemie logowania, uzyskali dostęp do kont pracowników OpenAI w serwisach ChatGPT i Codex.
Wiele z tych kont było powiązanych z usługami Gmail, Outlook, Drive, Slack, GitHub i innymi. Jako dowód koncepcji (proof of concept), za pośrednictwem przejętego konta Codex pracownika otwarto pull request w wewnętrznym monorepo OpenAI.
OpenAI od czasu wykrycia problemu załatało tę podatność, a zespół Hacktron otrzymał nagrodę w wysokości 6 500 dolarów za zgłoszenie luki.
Dlaczego to ważne
AnalizaPrzypadek ten ilustruje nowy wektor ataku, w którym modele AI są wykorzystywane do automatyzacji odkrywania podatności w złożonej infrastrukturze dużych firm technologicznych.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami
Powiązane w ekosystemie
Praktyczne poradniki, kluczowa terminologia i skille agentów
AI Radar: GPT-6.1 Terra, Gemini 4 Carbon, Mistral Large 4 i zmiany cen OpenAI oraz Anthropic
Przegląd najnowszych wiadomości AI: nowe modele LLM, zmiany subskrypcji OpenAI i Anthropic, modele świata, generatory wideo oraz szczegóły korporacyjne.
OpenAI GPT (Flagowe modele z serii GPT)
Główna, uniwersalna linia dużych modeli językowych od OpenAI (GPT-4, GPT-4o). Optymalizowana pod kątem złożonej analizy tekstu, programowania, kreatywności oraz codziennej pracy intelektualnej.
Claude Haiku (Szybkie, kompaktowe modele Anthropic)
Najmniejszy i najszybszy model w ofercie Anthropic. Zaprojektowany do błyskawicznych odpowiedzi, masowej klasyfikacji tekstu, ekstrakcji danych oraz routingu agentowego przy minimalnych kosztach.
Cztery wskazówki do CV od szefa rozwoju zastosowań AI w OpenAI
Wulfie Bain, szef rozwoju zastosowań AI w OpenAI, wskazał cztery zasady: zwięzłość, trafność, nacisk na wyniki i najważniejsze osiągnięcia na początku.