Qwen3.8-Omni-Flash: Modelo Multimodal com Contexto de 1 Milhão de Tokens
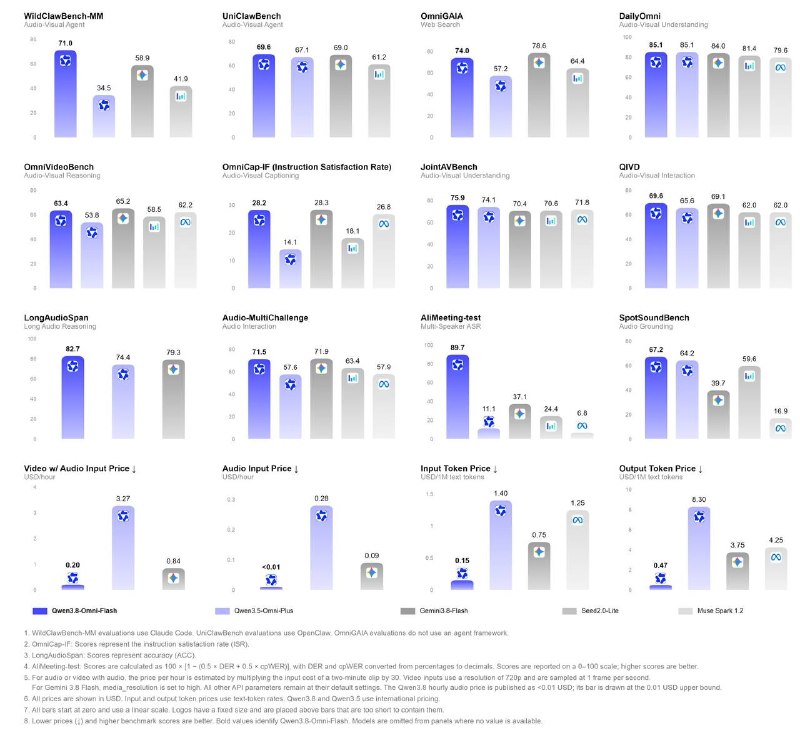
A Qwen lançou o Qwen3.8-Omni-Flash, um modelo multimodal com janela de contexto de 1 milhão de tokens, melhor compreensão de vídeo e custos drasticamente reduzidos para processamento de áudio e vídeo.
Lançamento do Qwen3.8-Omni-Flash
Desenvolvedores descrevem esta versão como o primeiro modelo multimodal da linha construído em torno de capacidades agênticas. Ele compreende texto, imagens, áudio e vídeo como entrada, oferecendo uma janela de contexto de 1 milhão de tokens.
A compreensão e o processamento de vídeo foram significativamente aprimorados: o modelo entende muito melhor vídeos longos, pode gerar relatórios de pesquisa aprofundada ou legendas baseadas neles e não alucina códigos de tempo (timecodes). Enquanto isso, as capacidades de texto são mantidas no nível do padrão Qwen-3.8 Flash.
No geral, este modelo foi projetado como um elo intermediário para um pipeline completo futuro, destinado a cenários como edição de vídeo, tradução, comentários sobre filmes, criação de conteúdo, entre outros.
Em comparação ao anterior Qwen3.5-Omni-Flash, o consumo de tokens também diminuiu consideravelmente, resultando em preços mais baixos:
- O processamento de áudio é 98% mais barato;
- O processamento de áudio-vídeo é mais de 93% mais barato.
Isso é alcançado com desempenho comparável ao Gemini 3.8 Flash.
O modelo já está disponível na API e no Qwen Chat.
Por que isso importa
AnáliseEste lançamento é crucial para desenvolvedores de IA que trabalham com dados multimodais, oferecendo alto desempenho e capacidades agênticas por uma fração do custo anterior, especialmente para aplicações intensivas em vídeo.
Debater na comunidade
Compartilhe suas dúvidas e insights com desenvolvedores