L’architecture « révolutionnaire » d’Astra chez OpenAI : une fabrication journalistique
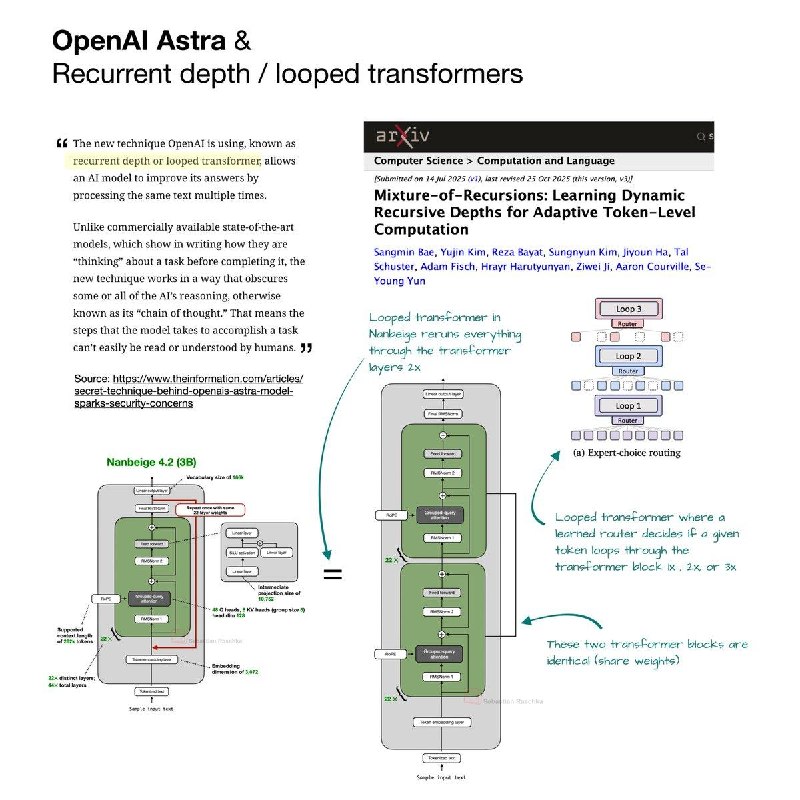
Une récente vague de spéculations sur l'architecture du modèle Astra d'OpenAI s'est avérée infondée, révélant des techniques connues et mal interprétées par la presse.
Récemment, un article très médiatisé a circulé en ligne, affirmant que le nouveau modèle d'OpenAI, codénommé Astra, repose sur une architecture révolutionnaire baptisée « profondeur récurrente » ou « transformer bouclé ».
Le concept derrière ce « transformer bouclé » est simple : au lieu de traverser une pile fixe de couches différentes une seule fois, le modèle fait passer l'état caché à travers le même bloc de couches plusieurs fois avant de générer le token suivant.
Les experts en apprentissage automatique ont immédiatement reconnu qu'il n'y avait là rien de révolutionnaire. Il s'agit d'une astuce architecturale bien connue, qui remonte aux travaux de Google intitulés « Mixture-of-Recursions », présentés lors de la conférence NeurIPS. Cette idée a été largement exploitée dans de nombreux projets open source.
Malgré cela, l'engouement suscité par l'article de The Information a atteint des sommets. L'article prétend également que le transformer bouclé dissimule la chaîne de raisonnement (chain-of-thought). Contrairement aux modèles qui affichent leur raisonnement sous forme de texte, les étapes internes du transformer bouclé seraient cachées au sein du modèle, rendant le processus inaccessible aux humains.
Ainsi, l'information s'est rapidement transformée d'un détail technique en un débat sur la sécurité de l'IA. OpenAI a été accusé d'avoir franchi une ligne rouge. Cependant, la thèse selon laquelle la chaîne de pensée serait cachée s'est révélée très controversée.
Jakub Pachocki a publiquement réfuté ces affirmations, qualifiant le reportage de trompeur. Sebastian Raschka a analysé la situation avec précision :
« Peut-être que le journaliste de The Information faisait référence à une autre technique ou a mal compris le fonctionnement du transformer bouclé.
La simple réutilisation des couches ne supprime pas la chaîne de pensée visible ; elle ajoute simplement des calculs aux états cachés avant la génération du prochain token, exactement comme le font les couches standard d'un transformer.
Le seul lien plausible qui peut être établi est que si le modèle effectue davantage de passes récurrentes, il pourrait nécessiter moins de tokens intermédiaires de raisonnement. Autrement dit, plus de calculs se produisent dans des activations latentes illisibles sous forme de texte. Mais le même effet pourrait être obtenu en augmentant simplement la taille du modèle – par exemple, en passant de GPT-5.6 Luna à GPT-5.6 Sol.
À vous de tirer vos propres conclusions. »
Pourquoi c'est important
AnalyseCet épisode souligne l'importance cruciale d'examiner avec esprit critique les actualités technologiques, où les mythes peuvent se propager aussi vite que les innovations. Une compréhension précise des architectures permet d'éviter des alarmes injustifiées sur la sécurité de l'IA.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs