A Arquitetura 'Revolucionária' da Astra da OpenAI: Uma Fabricação Jornalística
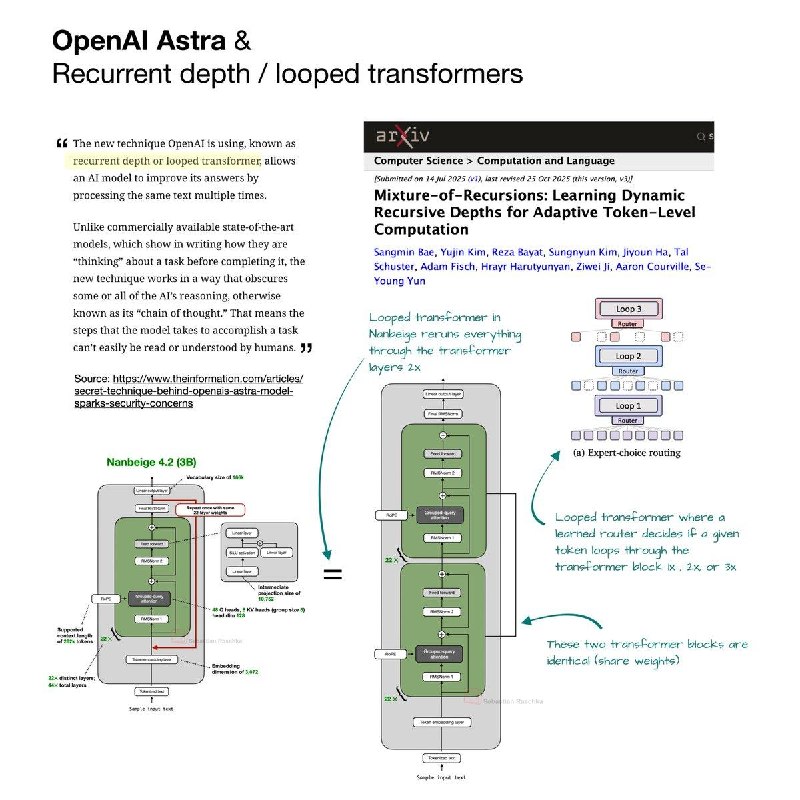
Desmistificamos as alegações sobre a nova arquitetura de modelo da OpenAI, revelando que o conceito de 'transformador em loop' não é uma inovação, mas sim uma técnica conhecida.
Recentemente, um artigo viralizou online alegando que o novo modelo da OpenAI, codinome Astra, baseia-se numa arquitetura revolucionária chamada "profundidade recorrente" ou "transformador em loop".
A ideia por trás do "transformador em loop" é que, em vez de passar por uma pilha fixa de várias camadas apenas uma vez, o modelo passa o estado oculto pelo mesmo bloco de camadas múltiplas vezes antes de emitir o próximo token.
Quem acompanha artigos de ML já entendeu neste ponto que não há revolução aqui. Trata-se de um truque arquitetônico bem conhecido que remonta ao trabalho do Google, "Mixture-of-Recursions", apresentado na NeurIPS. Esta ideia foi utilizada inúmeras vezes em código aberto.
No entanto, o hype gerado pelo artigo da The Information quase atingiu estratosferas. O texto também afirma que o transformador em loop esconde a cadeia de pensamento (chain-of-thought). Especificamente, ao contrário dos modelos que mostram raciocínio em texto, os passos no transformador em loop estariam ocultos dentro do modelo e, portanto, inacessíveis aos humanos.
Assim, a notícia transformou-se rapidamente de um detalhe arquitetônico num debate sobre segurança de IA. A OpenAI foi acusada de cruzar uma linha vermelha. Contudo, a tese sobre a CoT oculta revela-se muito controversa.
Jakub Pachocki contra-atacou publicamente, afirmando que o relatório é enganoso. Sebastian Raschka escreveu sobre o tema da seguinte forma:
"Talvez o jornalista da The Information tenha se referido a outra técnica ou mal interpretado como funciona o transformador em loop.
A simples reutilização de camadas não suprime a cadeia de pensamento visível; ela meramente adiciona computações aos estados ocultos antes de gerar o próximo token, assim como fazem as camadas de transformadores regulares.
A única conexão plausível que pode ser estabelecida é que, se o modelo fizer mais dessas passagens recorrentes, ele pode exigir menos tokens de raciocínio intermediários. Ou seja, mais computações ocorrem em ativações latentes que não podem ser lidas como texto. Mas o mesmo efeito poderia ser alcançado simplesmente aumentando o tamanho do modelo – por exemplo, transitando do GPT-5.6 Luna para o GPT-5.6 Sol.
Que conclusão você tira disso, cabe a você decidir."
Por que isso importa
AnáliseEste caso ilustra a necessidade crítica de avaliar notícias tecnológicas, especialmente no campo da IA, onde mitos se espalham rapidamente. Compreender detalhes arquitônicos ajuda a evitar desinformação e pânico desnecessário.
Debater na comunidade
Compartilhe suas dúvidas e insights com desenvolvedores