Архітектура нової моделі OpenAI Astra: міф чи реальність?
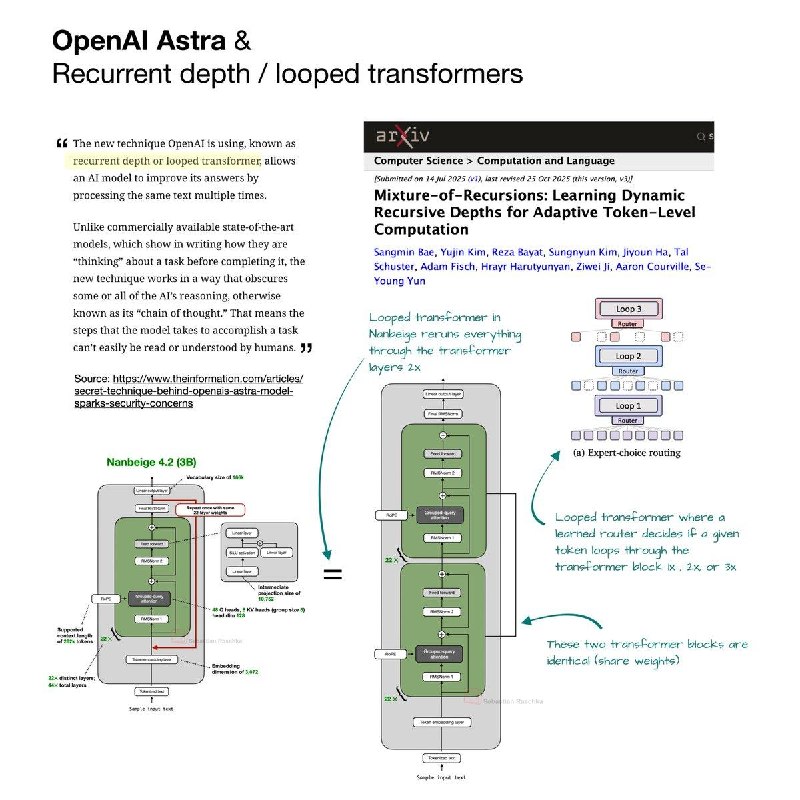
Стаття розглядає нову модель OpenAI Astra та її архітектуру, спростовуючи міфи про революційність її дизайну.
На днях по мережі розлетілася гучна стаття, в якій стверджувалося, що в основі нової моделі OpenAI під кодовою назвою Astra лежить революційна архітектура «recurrent depth» або «looped transformer».
Ідея «looped transformer» полягає в тому, що замість того, щоб проганяти фіксований стек різних шарів один раз, модель проганяє приховане стан через один і той же блок шарів кілька разів перед тим, як видати наступний токен.
Ті, хто слідкує за статтями в галузі машинного навчання, вже на цьому етапі зрозуміли, що жодної революції тут немає. Це досить відомий невеликий архітектурний трюк, який походить з роботи Google "Mixture-of-Recursions" з NeurIPS. Цю ідею вже багато разів використовували в опенсорсі.
Проте, хайп статті досяг стратосфери. Окрім розповідей про революційну архітектуру, в тексті також стверджується, що looped transformer приховує chain-of-thought. Тобто, на відміну від моделей, які демонструють міркування текстом, в looped transformer ці кроки приховані всередині моделі, і тому недоступні людині.
Таким чином, новина швидко перетворилася з архітектурної деталі в суперечку про безпеку штучного інтелекту. OpenAI вже звинуватили в тому, що вони переходять межу. Але насправді сам тезис про приховані CoT виявляється дуже спірним.
Якуб Пахоцкий публічно заперечив, заявивши, що репортаж вводить в оману. А Себастьян Рашка написав про це так:
"Можливо, журналіст The Information мав на увазі якусь іншу техніку або неправильно зрозумів, як працює looped transformer.
Само по собі повторне використання шарів не подавляє видимий chain-of-thought, воно лише додає обчислення в прихованих станах перед генерацією чергового токена, так само, як це роблять звичайні шари трансформера.
Єдина правдоподібна зв'язок, яку можна виділити: якщо модель робить більше таких рекуррентних проходів, їй може знадобитися менше проміжних токенів-роздумів. Тобто більше обчислень відбувається в латентних активаціях, які не можна прочитати як текст. Але точно такий же ефект дало б і просте збільшення розміру моделі – наприклад, перехід від GPT-5.6 Luna до GPT-5.6 Sol.
Який висновок напрошується, вирішуйте самі.
Чому це важливо
АналітикаЦя стаття підкреслює важливість критичного сприйняття новин про технології, особливо в контексті AI, де міфи можуть швидко поширюватися. Розуміння архітектурних деталей може допомогти уникнути непорозумінь у галузі.
Обговорити новину у спільноті
Діліться своїм досвідом та думками з ШІ-розробниками
Пов'язані матеріали екосистеми
Практичні гайди, термінологія та агентські скіли
Чотири поради щодо резюме від керівника напрямку прикладного ШІ в OpenAI
Керівник напрямку прикладної розробки ШІ в OpenAI Вульфі Бейн назвав чотири ключові правила резюме: стислість, релевантність, акцент на результатах і правильний порядок досягнень.
AI Radar: GPT-6.1 Terra, Gemini 4 Carbon, Mistral Large 4 і зміни тарифів OpenAI та Anthropic
Огляд свіжих новин AI: оновлення великих мовних моделей, зміни підписок OpenAI та Anthropic, а також нові world-моделі, відеогенератори й корпоративні фінансові деталі.
Частина II. Архітектура ШІ-агентів: від моделі до пам'яті та інструментів
Глибоке інженерне занурення: токенізація, KV-кеш, детермінізм семплінгу, тренувальний стек, квантування, контекстна інженерія, стек безпеки, виробничий RAG, ReAct та мультиагентні swarm-системи.
OpenAI GPT (Флагманські моделі серії GPT)
Головна універсальна лінійка великих мовних моделей від OpenAI (GPT-4, GPT-4o). Оптимізована для складного текстового аналізу, програмування, творчості та щоденної інтелектуальної роботи.