Die „revolutionäre“ Architektur von OpenAIs Astra: Eine journalistische Fiktion
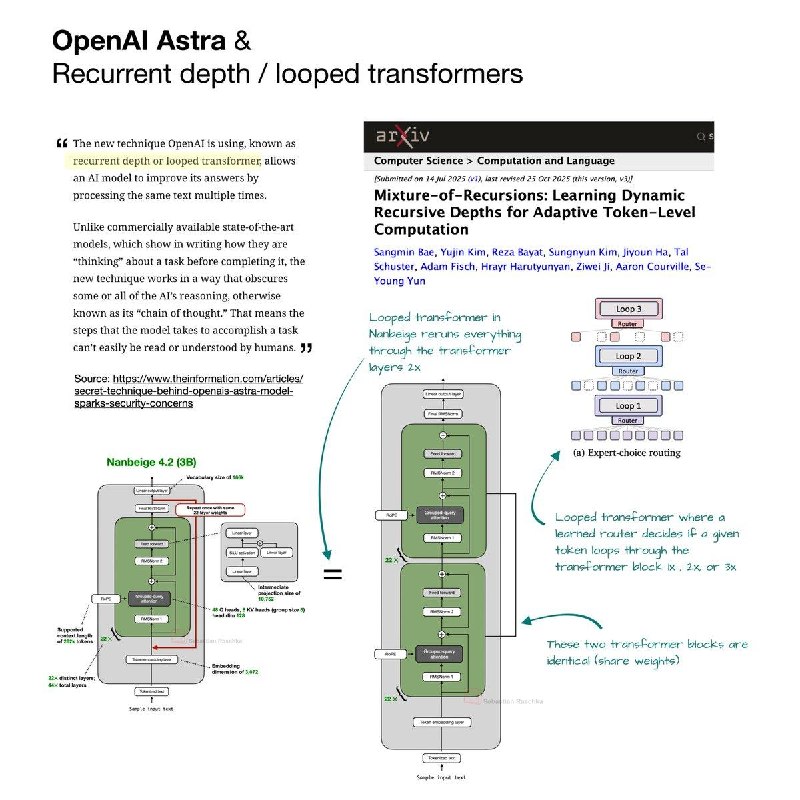
Ein viraler Artikel über OpenAIs neues Modell Astra und dessen angeblich revolutionäre „Looped Transformer“-Architektur entpuppt sich als irreführend. Die vermeintliche Sicherheitsbedrohung durch versteckte Gedankengänge basiert auf einem Missverständnis bekannter ML-Techniken.
Kürzlich verbreitete sich ein lautstarker Artikel online, der behauptete, das neue OpenAI-Modell mit dem Codenamen Astra basiere auf einer revolutionären Architektur namens „Recurrent Depth“ oder „Looped Transformer“.
Das Konzept des „Looped Transformers“ sieht vor, dass das Modell den verborgenen Zustand (Hidden State) nicht nur einmal durch einen festen Stapel verschiedener Schichten führt, sondern mehrfach durch denselben Block von Schichten iteriert, bevor das nächste Token ausgegeben wird.
Wer sich mit der aktuellen Literatur zum maschinellen Lernen auskennt, erkannte sofort: Hier liegt keine Revolution vor. Es handelt sich um einen bekannten architektonischen Trick, der auf Googles Arbeit „Mixture-of-Recursions“ vom NeurIPS zurückgeht. Diese Idee wurde bereits vielfach in Open-Source-Projekten implementiert.
Dennoch erreichte die Hype-Welle rund um den Artikel von The Information beinahe stratosphärische Höhen. Der Text behauptet zudem, der Loop Transformer verberge den Chain-of-Thought (CoT). Im Gegensatz zu Modellen, die ihre Schlussfolgerungen im Text offenlegen, seien die Schritte beim Loop Transformer im Inneren des Modells versteckt und für Menschen unzugänglich.
Damit wandelte sich die Nachricht schnell von einem technischen Detail zu einer Debatte über KI-Sicherheit. OpenAI wurde vorgeworfen, eine rote Linie überschritten zu haben. Doch die These vom versteckten CoT ist hochumstritten.
Jakub Pachocki widersprach öffentlich und bezeichnete den Bericht als irreführend. Sebastian Raschka analysierte die Situation wie folgt:
„Vielleicht meinte der Journalist von The Information eine andere Technik oder missverstand die Funktionsweise des Loop Transformers.
Die bloße Wiederverwendung von Schichten unterdrückt den sichtbaren Chain-of-Thought nicht; sie fügt lediglich Berechnungen zu den Hidden States hinzu, bevor das nächste Token generiert wird – genau wie bei regulären Transformer-Schichten.
Der einzig plausible Zusammenhang besteht darin, dass das Modell bei mehr rekurrenten Durchläufen weniger Zwischen-Token für das Reasoning benötigt. Das bedeutet, dass mehr Berechnungen in latenten Aktivierungen stattfinden, die nicht als Text lesbar sind. Derselbe Effekt könnte jedoch einfach durch eine Vergrößerung des Modells erzielt werden – etwa durch den Wechsel von GPT-5.6 Luna zu GPT-5.6 Sol.
Welche Schlussfolgerung man daraus zieht, bleibt jedem selbst überlassen.“
Warum das wichtig ist
AnalyseDieser Fall unterstreicht die Notwendigkeit, technologische Nachrichten kritisch zu prüfen, da Mythen im KI-Bereich schnell viral gehen können. Ein fundiertes Verständnis der Architekturdetails ist essenziell, um Fehlinterpretationen und unnötige Sicherheitsdebatten zu vermeiden.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern