Rewolucyjna i niebezpieczna architektura OpenAI Astra? Dziennikarska fikcja
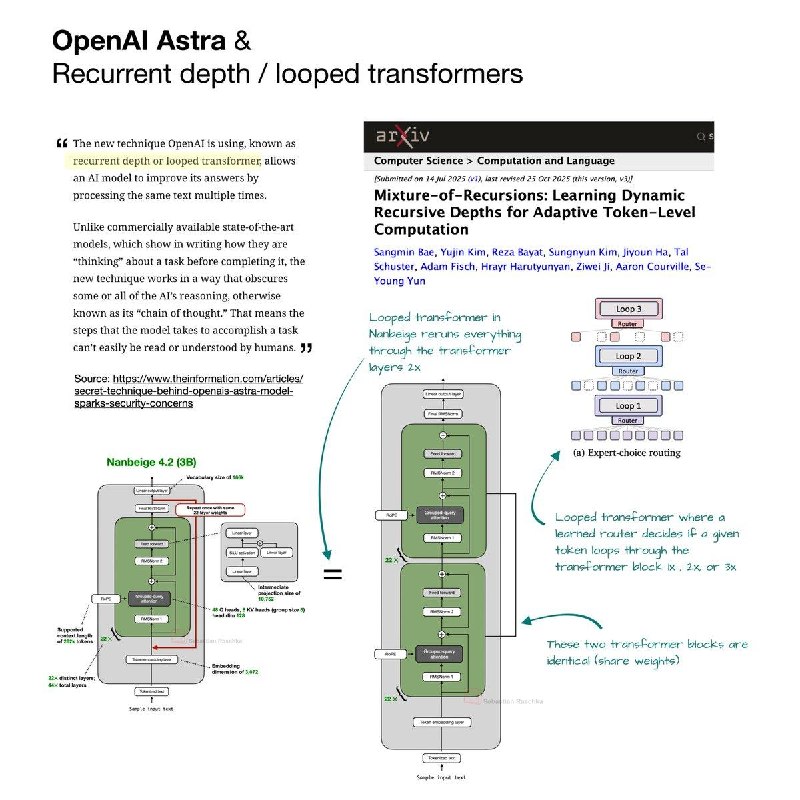
Artykuł obala mity dotyczące rzekomo rewolucyjnej architektury modelu Astra od OpenAI, wskazując na błędną interpretację techniczną oraz przesadzone obawy o bezpieczeństwo AI.
Ostatnio w internecie krążył głośny artykuł twierdzący, że nowy model OpenAI, oznaczony kodową nazwą Astra, opiera się na rewolucyjnej architekturze zwanej „recurrent depth” lub „looped transformer” (transformer z pętlą).
Idea stojąca za „looped transformer” polega na tym, że zamiast jednokrotnego przepuszczania danych przez stały stos warstw, model wielokrotnie przesyła stan ukryty przez ten sam blok warstw przed wygenerowaniem kolejnego tokenu.
Osoby śledzące literaturę z zakresu uczenia maszynowego (ML) szybko zauważyły, że nie ma tu żadnej rewolucji. Jest to znany trik architektoniczny, którego korzenie sięgają pracy Google’a pt. „Mixture-of-Recursions” zaprezentowanej na konferencji NeurIPS. Pomysł ten był już wielokrotnie wykorzystywany w projektach open-source.
Niemniej jednak szum medialny wokół artykułu The Information osiągnął niemal stratosferyczne rozmiary. Publikacja sugeruje również, że looped transformer ukrywa proces myślenia (chain-of-thought). W przeciwieństwie do modeli, które prezentują rozumowanie w formie tekstu, kroki w architekturze z pętlą mają być niewidoczne dla człowieka, ponieważ są zaszyte głęboko wewnątrz modelu.
W efekcie wiadomość szybko przekształciła się z szczegółu technicznego w debatę nad bezpieczeństwem AI. OpenAI zostało oskarżone o przekroczenie granic etycznych. Jednak teza o ukrytym CoT okazuje się bardzo kontrowersyjna.
Jakub Pachocki publicznie skontrował te doniesienia, stwierdzając, że raport jest wprowadzający w błąd. Sebastian Raschka skomentował sprawę następująco:
„Być może dziennikarz z The Information miał na myśli inną technikę lub źle zrozumiał działanie looped transformera.
Samo ponowne użycie warstw nie tłumi widocznego łańcucha myślenia; jedynie dodaje obliczenia do stanów ukrytych przed wygenerowaniem kolejnego tokenu, dokładnie tak jak robią to zwykłe warstwy transformera.
Jedynym prawdopodobnym powiązaniem jest to, że jeśli model wykonuje więcej takich rekurencyjnych przejść, może wymagać mniejszej liczby pośrednich tokenów rozumowania. Oznacza to, że więcej obliczeń zachodzi w aktywacjach latentnych, których nie da się odczytać jako tekst. Ale ten sam efekt można osiągnąć po prostu zwiększając rozmiar modelu – na przykład przechodząc z GPT-5.6 Luna do GPT-5.6 Sol.
Jakie wnioski wyciągniecie, zależy od was.”
Dlaczego to ważne
AnalizaPrzypadek ten podkreśla konieczność krytycznej oceny newsów technologicznych, szczególnie w branży AI, gdzie mity rozprzestrzeniają się błyskawicznie. Zrozumienie niuansów architektonicznych pozwala uniknąć fałszywych alarmów dotyczących bezpieczeństwa sztucznej inteligencji.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami