Революционная и очень опасная архитектура новой Astra оказалась выдумкой журналистов
Статья рассматривает утверждения о модели Astra от OpenAI, опровергая мифы о ее революционном дизайне.
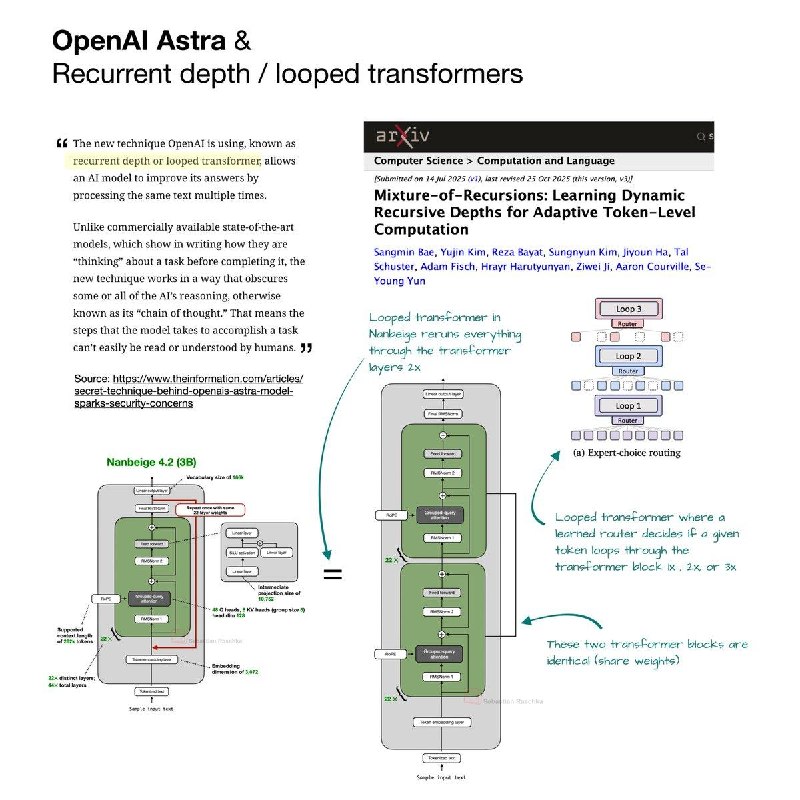
На днях по сети разлетелась громкая статья, в которой утверждалось, что в основе новой модели OpenAI под кодовым названием Astra лежит революционная архитектура «recurrent depth» или «looped transformer».
Идея «looped transformer» заключается в том, что вместо того, чтобы гонять фиксированный стек различных слоев ровно один раз, модель прогоняет скрытое состояние через один и тот же блок слоев несколько раз перед тем, как выдать следующий токен.
Те, кто следит за ML-статьями, уже на этом моменте поняли, что никакой революции тут нет. Это довольно известный небольшой архитектурный трюк, который восходит корнями к работе Google "Mixture-of-Recursions" с NeurIPS. Мы разбирали ее здесь: Эту идею уже много раз использовали в опенсорсе.
Тем не менее, хайп статьи The Information почти достиг стратосферы. Дело в том, что помимо рассказов о революционной архитектуре, в тексте также утверждается, что looped transformer скрывает chain-of-thought. Точнее: в отличие от моделей, которые показывают рассуждения текстом, в looped transformer эти шаги скрыты внутри модели, и поэтому человеку недоступны.
Так что новость почти сразу превратилась из архитектурной детали в спор о безопасности ИИ. OpenAI уже успели обвинить в том, что они переходят черту. Но на деле сам тезис про скрытые CoT оказывается очень спорным.
Якуб Пахоцкий публично возразил, заявив, что репортаж вводит в заблуждение. А Себастьян Рашка написал про это вот так:
"Возможно, журналист The Information имел в виду какую-то другую технику или неверно понял, как работает looped transformer.
Само по себе повторное использование слоев не подавляет видимый chain-of-thought, оно лишь добавляет вычисления в скрытых состояниях перед генерацией очередного токена, точно так же, как это делают обычные слои трансформера.
Единственная правдоподобная связь, которую можно выделить: если модель делает больше таких рекуррентных проходов, ей может требоваться меньше промежуточных токенов-рассуждений. То есть больше вычислений происходит в латентных активациях, которые нельзя прочитать как текст. Но точно такой же эффект дало бы и простое увеличение размера модели – например, переход от GPT-5.6 Luna к GPT-5.6 Sol.
Какой вывод напрашивается, решайте сами.
Почему это важно
АналитикаЭта статья подчеркивает важность критического восприятия новостей о технологиях, особенно в контексте ИИ, где мифы могут быстро распространяться. Понимание архитектурных деталей может помочь избежать недоразумений в области.
Обсудить в сообществе
Делитесь опытом и мыслями с ИИ-разработчиками
Связанные материалы экосистемы
Практические гайды, терминология и агентские скиллы
Четыре совета по резюме от руководителя направления прикладного ИИ-разработки в OpenAI
Вульфи Бейн, руководитель направления прикладной ИИ-разработки в OpenAI, назвал четыре правила резюме: краткость, релевантность, акцент на результатах и вынос важных достижений на начало.
Сэм Альтман переименовал аккаунт в X в Ram Altman
Сэм Альтман изменил отображаемое имя своего аккаунта в X на Ram Altman.
Часть I. Архитектура ИИ-агентов: фундаментальные блоки
Одиннадцать фундаментальных строительных блоков современного ИИ-агента: таксономия моделей, агентный рантайм, техники промптинга, дистилляция, архитектура навыков (skills), память, function calling и FinOps.
Часть II. Архитектура ИИ-агентов: от модели до памяти и инструментов
Глубокое инженерное погружение: токенизация, KV-кэш, детерминизм сэмплинга, тренировочный стек, квантование, контекстная инженерия, стек безопасности, производственный RAG, ReAct и мультиагентные swarm-системы.