Deux cases à cocher dans l'API triplent les résultats de GPT-5.6 sur ARC-AGI-3
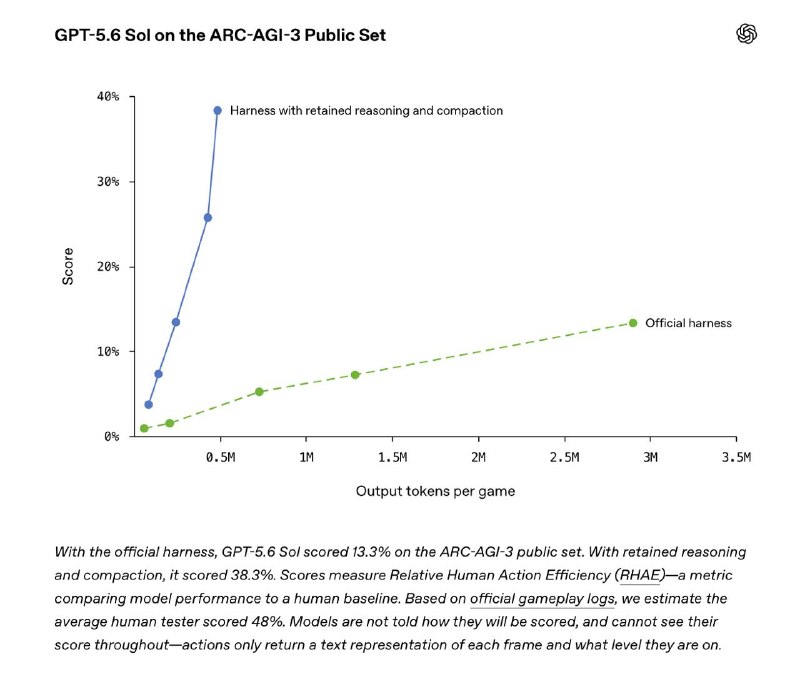
Une étude d'OpenAI révèle que la configuration du harnais de test, et non le modèle lui-même, était responsable des faibles scores initiaux de GPT-5.6 Sol sur le benchmark ARC-AGI-3.
Deux cases à cocher dans l'API triplent les résultats de GPT-5.6 sur ARC-AGI-3
OpenAI a publié aujourd'hui une étude fascinante démontrant que la manière dont nous testons un modèle peut être aussi cruciale que ce que nous testons.
Lors de la sortie de GPT-5.6 Sol, ses performances sur le benchmark ARC-AGI-3 étaient suspectement faibles pour un modèle de cette envergure : seulement 7,8 %. Pourtant, Sol excellait dans d'autres tâches complexes, comme Pokémon FireRed ou la résolution de l'hypothèse de double couverture des cycles. L'équipe a donc décidé d'investiguer la cause de cette anomalie.
Rappelons qu'ARC-AGI-3 est un benchmark conçu pour les agents. Pour interagir avec l'environnement, les modèles nécessitent un harnais (wrapper) qui définit ce que le modèle perçoit à chaque étape, comment les outils sont appelés et comment le contexte est géré. Par souci d'équité, l'environnement ARC-AGI-3 utilise un harnais universel minimaliste. C'est précisément cette universalité qui posait problème.
Deux facteurs critiques ont été identifiés :
- Effacement du raisonnement privé : Après chaque action, l'intégralité du raisonnement interne du modèle était supprimée. Sol ne pouvait donc pas voir ses propres plans ni sa logique des étapes précédentes.
- Fenêtre glissante rigide : À mesure que l'historique s'allongeait, les anciennes actions devenaient invisibles au modèle en raison d'une troncature brutale du contexte.
Or, Sol a été spécifiquement entraîné pour conserver son raisonnement entre les étapes. Le harnais standard désactivait cette capacité native, faisant chuter les performances.
Les résultats corrigés
En ajustant simplement deux paramètres — l'activation de la rétention du raisonnement entre les appels et le remplacement de la troncature par une compression intelligente du contexte (comme utilisé dans ChatGPT et Codex en production) — les résultats se sont envolés.
- Score officiel (harnais standard) : 13,3 %
- Score optimisé (nouveau harnais) : 38,3 %
Ce gain de performance s'est accompagné d'une réduction de six fois la consommation de tokens en sortie. Pour référence, le score moyen humain sur ce benchmark est de 48 %.
La morale d'OpenAI
Cette étude souligne que les benchmarks mesurent non seulement la capacité brute du modèle, mais aussi la façon dont il est déployé. Il est impératif d'utiliser l'API Responses moderne plutôt que l'ancienne API Chat Completions lors de ces évaluations pour refléter fidèlement les capacités réelles des modèles actuels.
Pourquoi c'est important
AnalyseCette découverte met en lumière l'importance critique de la méthodologie de test dans l'évaluation des IA, montrant que les configurations logicielles peuvent masquer ou exalter les capacités réelles d'un modèle.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs