Jak dwa pola wyboru w API potroiły wyniki GPT-5.6 w teście ARC-AGI-3
OpenAI opublikowało badanie pokazujące, że zmiana ustawień testowych modelu GPT-5.6 drastycznie poprawiła jego wyniki w benchmarku ARC-AGI-3.
Jak dwa pola wyboru w API potroiły wyniki GPT-5.6 w teście ARC-AGI-3
Dziś OpenAI udostępniło interesujące badanie, które dowodzi, że czasem ważniejsze od tego, co testujemy, jest sposób, w jaki to robimy. Przyjrzyjmy się temu krok po kroku.
Po premierze modelu GPT-5.6 Sol wyniki uzyskane w benchmarku ARC-AGI-3 okazały się podejrzanie niskie jak na tak zaawansowaną technologię – wyniosły zaledwie 7,8%. Dzieje się tak mimo faktu, że Sol radził sobie świetnie w grze Pokémon FireRed oraz rozwiązywał złożone problemy logiczne, takie jak hipoteza podwójnego pokrycia cykli. Zespół postanowił zbadać przyczyny tej rozbieżności.
Przypomnijmy, że ARC-AGI-3 to benchmark dla agentów AI. Modele potrzebują więc specjalnej nakładki – tzw. harnessa – która definiuje, co model widzi na każdym etapie, jak wywoływane są narzędzia oraz co dzieje się z kontekstem rozmowy. Standardowo środowisko ARC-AGI-3 wykorzystuje najprostszy, uniwersalny harness, aby sprawiedliwie porównywać różne modele. Okazało się jednak, że problem leżał właśnie w tej uniwersalności.
Po pierwsze, po każdej akcji w grze całe prywatne rozumowanie modelu było usuwane, przez co Sol nie miał dostępu do swoich planów i wniosków z poprzednich kroków. Po drugie, ze względu na zastosowanie mechanizmu przesuwającego okna (sliding window), wraz z rosnącą historią interakcji starsze akcje stawały się niewidoczne dla modelu.
Tymczasem Sol został specjalnie wytrenowany do zachowywania ciągłości rozumowania między kolejnymi krokami. Harness dezaktywował tę funkcję, co skutkowało gwałtownym spadkiem wyników.
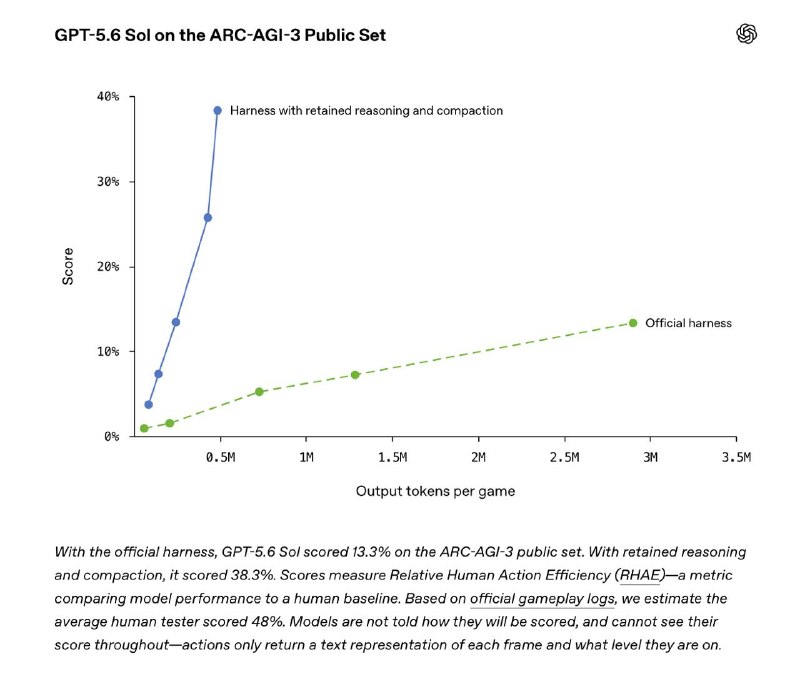
Spójrzmy teraz na wykres przedstawiony w badaniu. Zielona linia obrazuje wyniki modelu na publicznym zestawie danych ARC-AGI-3 przy użyciu oficjalnego harnessa. Niebieska linia reprezentuje konfigurację, w której włączono zachowanie rozumowania między wywołaniami oraz zastąpiono brutalne obcinanie historii kompresją kontekstu (są to te same ustawienia, które stosuje się w produkcyjnych wersjach ChatGPT i Codex). Wynik wzrósł z 13,3% do 38,3%, a jednocześnie zużycie tokenów wyjściowych spadło sześciokrotnie. Dla porównania: średni wynik człowieka wynosi 48%.
Wniosek z badania OpenAI jest jasny: benchmark mierzy nie tylko możliwości modelu, ale również sposób jego wykorzystania. Czas najwyższy zacząć stosować API Responses w takich testach zamiast przestarzałego Chat Completions.
Dlaczego to ważne
AnalizaBadanie podkreśla kluczową rolę konfiguracji testowej w uzyskiwaniu wiarygodnych wyników w benchmarkach AI. Zrozumienie wpływu zmian w metodologii testowania na końcowe rezultaty może znacząco przyspieszyć rozwój przyszłych modeli sztucznej inteligencji.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami