Wie zwei API-Optionen die Ergebnisse von GPT-5.6 bei ARC-AGI-3 verdreifachten
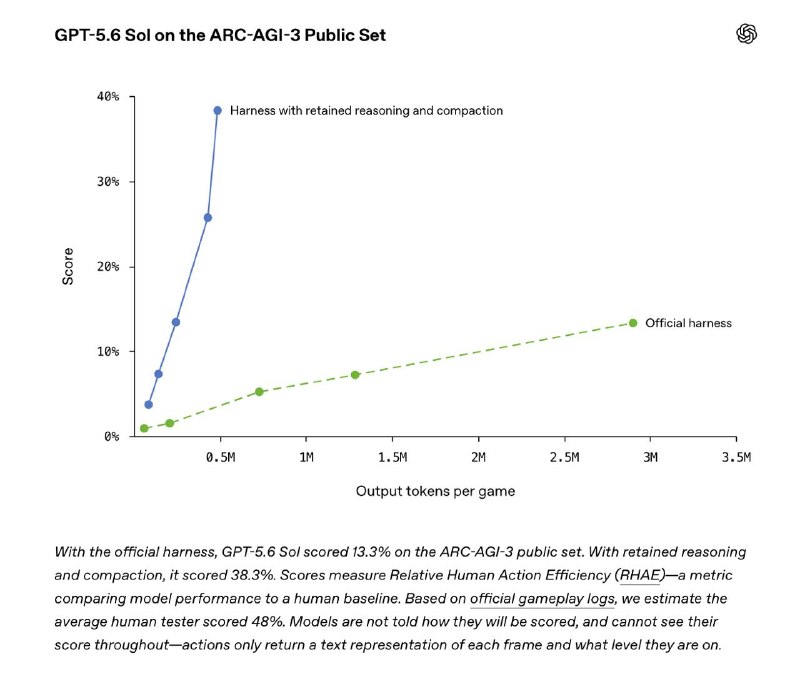
Eine neue OpenAI-Studie zeigt, dass die Testkonfiguration entscheidend für die Leistungsbewertung von GPT-5.6 ist: Durch die Aktivierung der Reasoning-Retention stieg die Punktzahl im ARC-AGI-3-Benchmark von 13,3 % auf 38,3 %.
Wie zwei API-Optionen die Ergebnisse von GPT-5.6 bei ARC-AGI-3 verdreifachten
Heute hat OpenAI eine interessante Studie veröffentlicht, die eindrucksvoll demonstriert, dass manchmal die Art und Weise des Testens wichtiger ist als das Objekt des Tests selbst. Doch gehen wir Schritt für Schritt vor.
Als GPT-5.6 Sol veröffentlicht wurde, fielen die Ergebnisse im Benchmark ARC-AGI-3 für ein so leistungsfähiges Modell verdächtig schwach aus – lediglich 7,8 %. Dies überraschte umso mehr, da Sol in anderen Bereichen wie Pokémon FireRed gute Leistungen erbrachte und beispielsweise die Hypothese zur doppelten Überdeckung von Zyklen erfolgreich löste. Das Team beschloss daher, den Ursachen auf den Grund zu gehen.
Zur Erinnerung: ARC-AGI-3 ist ein Benchmark für autonome Agenten. Dementsprechend benötigen Modelle für die Interaktion mit der Umgebung einen sogenannten Harness (Testrahmen), der definiert, was das Modell bei jedem Schritt sieht, wie Tools aufgerufen werden und wie mit dem Kontext umgegangen wird. Erwartungsgemäß nutzt die ARC-AGI-3-Umgebung einen einfachen, universellen Harness, um Modelle fair miteinander vergleichen zu können. Für OpenAI stellte sich jedoch heraus, dass genau diese Universalität das Problem war.
Erstens wurde nach jeder Aktion im Spiel das gesamte private Reasoning des Modells gelöscht, sodass Sol seine eigenen Pläne und Schlussfolgerungen aus vorherigen Schritten nicht mehr sehen konnte. Zweitens führte die Verwendung eines gleitenden Fensters dazu, dass ältere Aktionen mit wachsender Historie für das Modell unsichtbar wurden.
Sol wurde jedoch speziell darauf trainiert, sein Reasoning zwischen den Schritten beizubehalten. Der Standard-Harness deaktiverte diese Funktion, was zu einem drastischen Einbruch der Ergebnisse führte.
Betrachten wir nun die Daten genauer: Die grüne Linie repräsentiert die Ergebnisse des Modells auf dem öffentlichen ARC-AGI-3-Datensatz unter Verwendung des offiziellen Harness. Die blaue Linie zeigt die Ergebnisse eines modifizierten Harness, bei dem die Retention des Reasonings zwischen den Aufrufen aktiviert und die grobe Kürzung der Historie durch Kontextkompression ersetzt wurde (ähnlich den Einstellungen, die in der Produktion von ChatGPT und Codex verwendet werden). Das Ergebnis: 38,3 % gegenüber 13,3 %, bei gleichzeitig sechsmal geringerem Token-Verbrauch für die Ausgabe. Zum Vergleich: Der durchschnittliche menschliche Wert liegt bei 48 %.
Die Lehre aus der OpenAI-Studie lautet: Benchmarks messen nicht nur die Qualität des Modells, sondern auch dessen Nutzungskontext. Es ist an der Zeit, bei solchen Benchmarks die modernere Responses API anstelle der veralteten Chat Completions API einzusetzen.
Warum das wichtig ist
AnalyseDiese Studie unterstreicht die kritische Bedeutung der Testumgebung und -einstellungen für die genaue Bewertung von KI-Leistungsdaten. Sie verdeutlicht, dass technische Implementierungsdetails, wie die Handhabung von Kontext und Reasoning, die wahrgenommene Intelligenz eines Modells erheblich beeinflussen können.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern