Как две галочки в API утроили результат GPT-5.6 на ARC-AGI-3
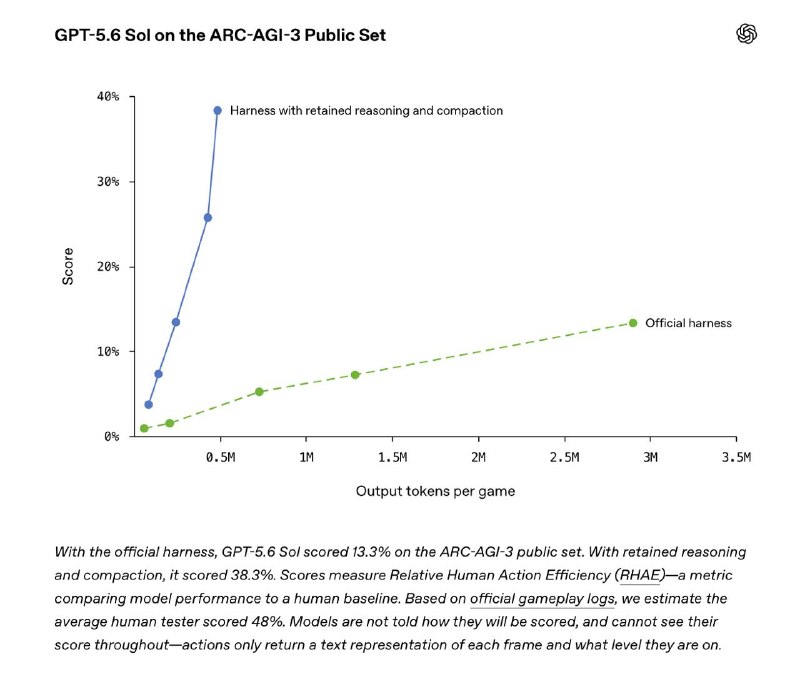
OpenAI опубликовала исследование, показывающее, как изменения в тестировании модели GPT-5.6 повлияли на ее результаты на ARC-AGI-3.
Как две галочки в API утроили результат GPT-5.6 на ARC-AGI-3
Сегодня OpenAI выпустила интересное исследование, которое показывает, что иногда важнее как мы тестируем, а не что мы тестируем. Но обо всем по порядку.
Когда вышла GPT-5.6 Sol, результаты на ARC-AGI-3 для такой сильной модели оказались подозрительно слабыми – всего 7.8%. И это при том, что Sol хорошо прошла Pokémon FireRed и решила, например, гипотезу о двойном покрытии циклов. Команда решила разобраться, в чем дело.
Напоминаем, что ARC-AGI-3 – это бенчмарк для агентов. Соответственно, модели для взаимодействия со средой нужна какая-то обвязка – харнесс – которая определяет, что модель видит на каждом шаге, как вызываются инструменты, что происходит с контекстом и тд. Ожидаемо, среда ARC-AGI-3 использует максимально простой универсальный харнесс, чтобы честно сравнивать модели между собой. Но для OpenAI именно в этой универсальности и оказалась зарыта собака.
Во-первых, после каждого действия в игре весь приватный ризонинг модели просто удалялся, так что Sol не видел собственных планов и рассуждений с прошлых шагов. Во-вторых, из-за использования скользящего окна по мере роста истории любые старые действия становились для модели невидимыми.
Но дело в том, что Sol была специально обучена именно с сохранением ризонинга между шагами. Харнесс эту фишку отрубил, и результаты посыпались.
А теперь внимание на график наверху. Зеленое – это результаты модели на public сете ARC-AGI-3 на официальном харнессе. А синее – на харнессе, в котором просто включили сохранение ризонинга между вызовами и заменили грубое обрезание истории на сжатие контекста (те же настройки используются в продакшене ChatGPT и Codex). 38.3% против 13.3%, и при этом расход токенов на вывод снизился в 6 раз. Для сравнения, средний результат человека – 48%.
Мораль от OpenAI: бенчмарк меряет не только модель, но и то, как именно ее используют. Как минимум, давно пора на подобных бенчмарках использовать Responses API вместо седого Chat Completions.
Почему это важно
АналитикаЭто исследование подчеркивает важность настроек тестирования для достижения точных результатов в бенчмарках AI. Понимание того, как изменения в тестировании влияют на результаты, может помочь в дальнейшем развитии AI-моделей.
Обсудить в сообществе
Делитесь опытом и мыслями с ИИ-разработчиками
Связанные материалы экосистемы
Практические гайды, терминология и агентские скиллы
Четыре совета по резюме от руководителя направления прикладного ИИ-разработки в OpenAI
Вульфи Бейн, руководитель направления прикладной ИИ-разработки в OpenAI, назвал четыре правила резюме: краткость, релевантность, акцент на результатах и вынос важных достижений на начало.
Сэм Альтман переименовал аккаунт в X в Ram Altman
Сэм Альтман изменил отображаемое имя своего аккаунта в X на Ram Altman.
Codex Skills для начинающих: автоматизация рабочих сценариев ИИ-агента
Практическое руководство по созданию и использованию Skills в Codex: анатомия SKILL.md, явная и авто-активация, разница между навыками, скриптами и тулами, Skills API и настройка безопасности.
JSON — структурированные данные для программ, API и AI-агентов
Полное практическое руководство по формату JSON: синтаксические правила, сериализация через parse/stringify, работа с REST API, валидация по JSON Schema и структурированный вывод для ИИ.