Cómo dos casillas en la API triplicaron los resultados de GPT-5.6 en ARC-AGI-3
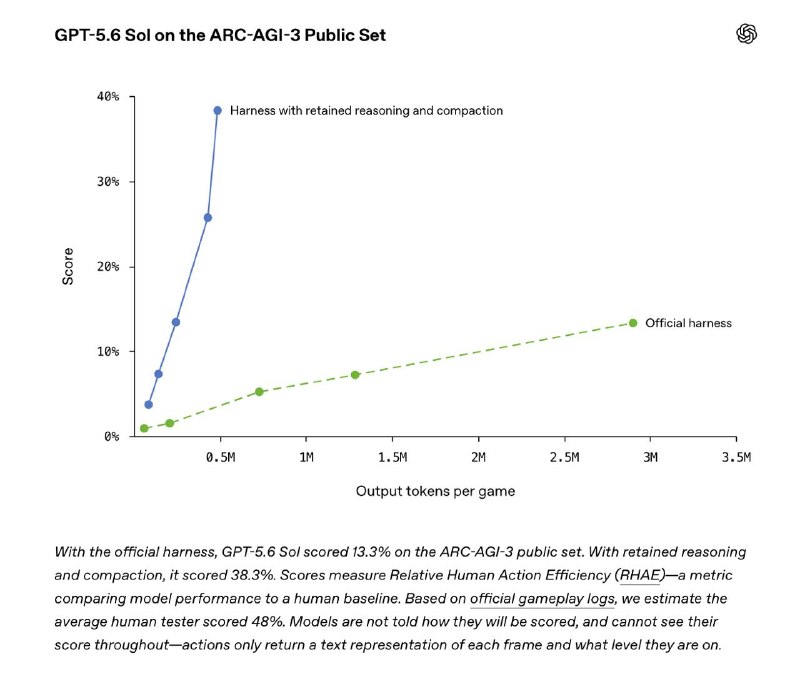
OpenAI ha publicado un estudio que muestra cómo los cambios en las pruebas del modelo GPT-5.6 afectaron su rendimiento en ARC-AGI-3.
Cómo dos casillas en la API triplicaron los resultados de GPT-5.6 en ARC-AGI-3
Hoy, OpenAI publicó un interesante estudio que muestra que a veces es más importante cómo probamos que qué probamos. Pero vayamos por partes.
Cuando se lanzó GPT-5.6 Sol, los resultados en ARC-AGI-3 para un modelo tan potente resultaron ser sospechosamente débiles: solo el 7.8%. Esto a pesar de que Sol se desempeñó bien en Pokémon FireRed y resolvió, por ejemplo, la hipótesis de la cobertura doble de ciclos. El equipo decidió investigar qué estaba pasando.
Recordemos que ARC-AGI-3 es un benchmark para agentes. Por lo tanto, los modelos para interactuar con el entorno necesitan algún tipo de envoltura: un harness que define lo que el modelo ve en cada paso, cómo se llaman las herramientas, qué sucede con el contexto, etc. Como era de esperar, el entorno ARC-AGI-3 utiliza el harness universal más simple para comparar modelos de manera justa. Pero para OpenAI, el problema estaba enterrado en esta universalidad.
En primer lugar, después de cada acción en el juego, todo el razonamiento privado del modelo se eliminaba, por lo que Sol no veía sus propios planes y razonamientos de pasos anteriores. En segundo lugar, debido al uso de una ventana deslizante, a medida que crecía la historia, cualquier acción antigua se volvía invisible para el modelo.
Sin embargo, Sol fue entrenada específicamente para retener el razonamiento entre pasos. El harness desactivó esta función y los resultados cayeron.
Ahora, presten atención al gráfico de arriba. La línea verde representa los resultados del modelo en el conjunto público de ARC-AGI-3 con el harness oficial. La línea azul representa el harness donde simplemente se habilitó la retención del razonamiento entre llamadas y se reemplazó el recorte brusco de la historia por la compresión del contexto (los mismos ajustes se utilizan en la producción de ChatGPT y Codex). 38.3% frente a 13.3%, y al mismo tiempo, el consumo de tokens para la salida se redujo 6 veces. Para comparar, el resultado promedio de un humano es del 48%.
La moraleja de OpenAI: el benchmark mide no solo el modelo, sino también cómo se utiliza. Al menos, ya es hora de utilizar la API de Respuestas en tales benchmarks en lugar de los obsoletos Chat Completions.
Por qué es importante
AnálisisEste estudio destaca la importancia de la configuración de pruebas para lograr resultados precisos en los benchmarks de IA. Comprender cómo los cambios en las pruebas afectan los resultados puede ayudar en el desarrollo futuro de modelos de IA.
Debatir en la comunidad
Comparte tus preguntas e ideas con desarrolladores
Relacionado en el ecosistema
Guías prácticas, terminología y skills de agentes
Cuatro consejos para el currículum del responsable de desarrollo de IA aplicada en OpenAI
Wulfie Bain, responsable de desarrollo de IA aplicada en OpenAI, destacó cuatro reglas: brevedad, relevancia, enfoque en resultados y logros más importantes al inicio.
Sam Altman cambia el nombre de su cuenta en X a Ram Altman
Sam Altman, CEO de OpenAI, cambió el nombre visible de su cuenta en X a Ram Altman.
Codex Skills para principiantes: automatización de flujos de trabajo con agentes de IA
Guía práctica para crear y ejecutar Skills en Codex: anatomía de SKILL.md, activación explícita y automática, diferencias entre skills, scripts y tools, Skills API y límites de seguridad.
JSON — Datos estructurados para programas, APIs y agentes de IA
Guía práctica y completa sobre JSON: especificación de sintaxis, serialización con parse y stringify, consumo de APIs REST, validación con JSON Schema y salidas estructuradas para LLMs.