Como duas opções na API triplicaram os resultados do GPT-5.6 no ARC-AGI-3
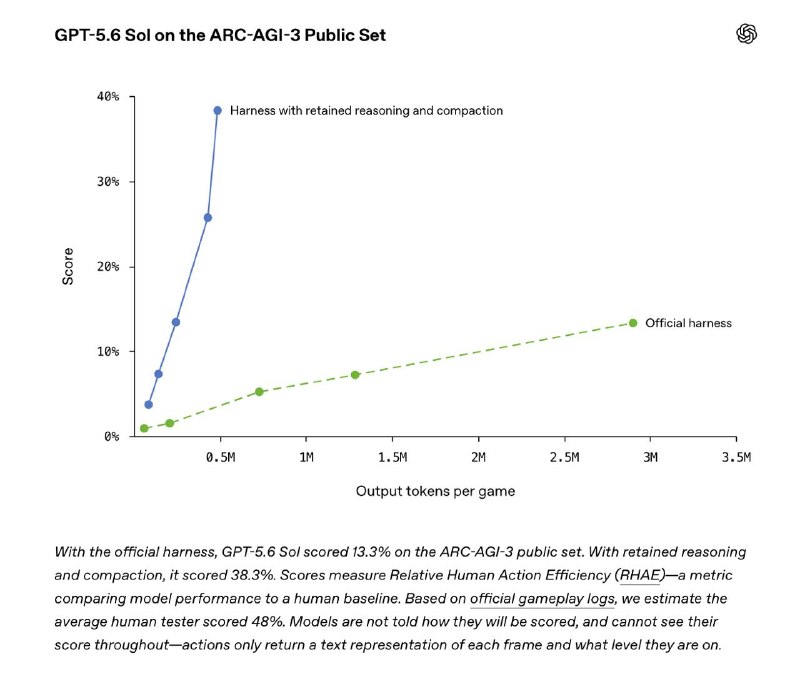
Um novo estudo da OpenAI revela que ajustes específicos no ambiente de teste (harness) aumentaram a pontuação do GPT-5.6 Sol no benchmark ARC-AGI-3 de 7,8% para 38,3%, demonstrando a crítica importância das configurações de inferência.
Como duas opções na API triplicaram os resultados do GPT-5.6 no ARC-AGI-3
Hoje, a OpenAI publicou um estudo interessante que ilustra como, por vezes, a forma como testamos é mais crucial do que o que estamos testando. Vamos analisar os fatos passo a passo.
Quando o modelo GPT-5.6 Sol foi lançado, seus resultados no benchmark ARC-AGI-3 pareceram suspeitamente baixos para um sistema tão poderoso: apenas 7,8%. Isso ocorreu apesar do fato de o Sol ter se saído bem em tarefas complexas, como jogar Pokémon FireRed e resolver hipóteses matemáticas específicas, como a dupla cobertura de ciclos. A equipe decidiu investigar a causa dessa discrepância.
Vale lembrar que o ARC-AGI-3 é um benchmark focado em agentes. Portanto, os modelos precisam de uma interface intermediária — um harness — que define o que o modelo observa em cada etapa, como as ferramentas são invocadas e como o contexto é gerenciado. Esperadamente, o ambiente ARC-AGI-3 utiliza o harness universal mais simples possível para permitir uma comparação justa entre diferentes modelos. No entanto, para a OpenAI, descobriu-se que o problema residia justamente nessa simplicidade excessiva.
Primeiramente, após cada ação no jogo, todo o raciocínio privado do modelo era apagado, impedindo que o Sol visse seus próprios planos e lógicas dos passos anteriores. Em segundo lugar, devido ao uso de uma janela deslizante, à medida que o histórico crescia, ações antigas tornavam-se invisíveis para o modelo.
Contudo, o Sol foi treinado especificamente para manter o raciocínio entre etapas. O harness padrão desativava essa capacidade, fazendo com que os resultados despencassem.
Agora, observe os dados apresentados no gráfico do estudo original. A linha verde representa os resultados do modelo no conjunto público do ARC-AGI-3 usando o harness oficial. A linha azul representa um harness ajustado onde foi habilitada a retenção de raciocínio entre chamadas e substituída a truncagem bruta do histórico por compressão de contexto (configurações idênticas às usadas na produção do ChatGPT e Codex). Os números falam por si: 38,3% versus 13,3%, com uma redução simultânea de 6 vezes no consumo de tokens de saída. Para fins de comparação, o resultado médio humano é de 48%.
A lição deixada pela OpenAI é clara: o benchmark mede não apenas o modelo, mas também como ele é utilizado. Pelo menos, chegou a hora de utilizar a Responses API em tais benchmarks, em vez da obsoleta Chat Completions.
Por que isso importa
AnáliseEste estudo destaca a vulnerabilidade dos benchmarks atuais a configurações de inferência inadequadas, sugerindo que a avaliação de agentes de IA deve evoluir para refletir melhor as capacidades reais de manutenção de contexto e raciocínio contínuo.
Debater na comunidade
Compartilhe suas dúvidas e insights com desenvolvedores